





Pinned Tweet
🚨 AI 自己写的推理引擎,把 Strata 和 Basalt 给办了?
GitHub 上刚冒出一个黑马推理引擎 Infernix,最骚的是作者在主页坦白:这项目的代码和文档,几乎全是 Claude Opus 5.5 和本地跑的 Qwen 联手搓出来的!
在单张 RTX 5090(Windows 11 / 84G 内存预算)上实测 Qwen3.8-Flash-Next:
1️⃣ NVFP4 权重下全面暴走:
首字响应时间(TTFT)比官方 Strata 快了整整 4.6~7.4 倍!在双路并发的 Agent 编码任务里,总耗时直接从 Strata 的 15.9 分钟缩减到 6.7 分钟——连前两天刚刷榜的 Basalt(8.9 分钟)都被它超了。
2️⃣ 不同量化的微妙反差:
- 跑 NVFP4:Infernix 优势明显,直接登顶;
- 跑 IQ3_S:Basalt 在 Prefill 阶段依然更快,但长文本解码时 Infernix 重新反超 25%。
3️⃣ 客观提醒:
目前的实测全部集中在吞吐速度上,具体生成质量和精度损失(Perplexity)还在测、尚未公开。
现在连底层高性能 C++/CUDA 推理引擎都开始由 AI 自己迭代自进化了。
📎 开源仓库:github.com/Wallawalla47/Infe…

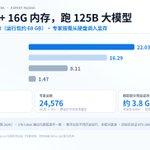
⚡ 一张 3060(12G 显存)+ 16G 内存,跑动了 125B 大模型,还飙到 22 tok/s!
一位个人开发者改了 llama.cpp,做了个新引擎 Betelgeuse,10 月 31 日刚开源。办法说白了就一句:模型装不下就别全装——哪个专家要用,临时从硬盘调哪个:
1️⃣ 成绩,同台机器对比:
• 第一次请求 16.29 tok/s,热起来 22.03;
• 原版 llama.cpp 只有 1.47,Strata 被 16G 内存憋着、只能开低内存模式,也只有 8.11;
• 这台机器还跑了约 190GB 的 Q8 高精度版,8–12 tok/s。
2️⃣ 怎么做到的:
• 模型雷打不动的部分只占 3.8GB,常驻显存;48 层、每层 512 个专家全放在硬盘上;
• 原版每算一层都要停下来问一次 CPU,一个字要等掉约 360 毫秒;他让显卡自己拿主意,中间不停;
• 热起来后,每吐一个字的读盘量从 235MB 砍到 12MB。
3️⃣ 最狠的是不掉质量:
• 专家一个没剪、精度一档没降,24,576 个专家和原文件逐个对过,一模一样;
• 连吐 576 个字,和原版逐字对齐,一个不差;
• 作者之前试过剪专家提速,发现会悄悄变笨,自己推翻重做的。
边界说清楚:22 是热起来的数字,不是冷启动;实测只开了 512 上下文(模型本身能到 262K),读长文也慢;目前只认 3060 这一张卡,已有 5080 用户测出反而变慢;引擎还是早期版本,改动也还没被 llama.cpp 官方合并。
但显存比模型小一个数量级的人,第一次有了不靠压精度也能跑的路。
📎 项目地址:github.com/Betelgeuse-AI/Bet…
#llamacpp #Qwen #本地大模型 #MoE #RTX3060 #开源


📱 一块 40 多块钱的 ESP32,把一部真 iPhone 直接交给 AI 操作了!不用 Mac、不用开发者账号、更不用越狱。
GitHub 开源项目 ESP32 iPhone Agent(作者 Henry Yuan),已狂揽 4.5k 星,这次还正式接进了 DeepSeek Harness(dsh),电脑上的编程 Agent 也能直接上手玩手机:
1️⃣ 眼睛走 AirPlay:
• 板子开热点装成 AirPlay 接收端,iPhone 屏幕直接镜像过去;
• 画面喂给任意 OpenAI 兼容的视觉模型当大脑。
2️⃣ 手走 USB HID:
• 板子伪装成鼠标 + 键盘,点、滑、打字全套;
• 接进 dsh 就是一组 MCP 工具:截图、点按、滑动、打字,看一眼做一步。
3️⃣ 门槛低到离谱:
• 一块 Seeed XIAO ESP32S3,淘宝约 40–50 元,固件在浏览器里就能刷;
• iPhone 只要 iOS 18+,App 走 TestFlight,板子直接由手机供电,运行时连电脑都不需要。
边界也说清楚:镜像只有 480×1040、最高 5 fps,每一步要等几秒;输密码和 Apple Pay 的界面 iOS 根本不给镜像,Agent 看不见;dsh 侧没有逐步确认,花钱、发消息、删数据之前,技能明文要求先问本人。
📎 项目地址:github.com/onehumanbeing/esp…
#ESP32 #iPhone #AIAgent #DeepSeek #开源硬件 #MCP

你的模型每秒吐 111 个 token,看起来飞快——但干完一件真活要 26 分钟。
Artificial Analysis 官方刚把这届前沿模型的"单任务真实耗时"排了出来(每任务输出 token ÷ 端到端输出速度,越低越好)。max 档最先干完活的是:
1️⃣ GPT-6 Luna(max):12.2 分钟
2️⃣ GPT-6.1 Terra(max):12.7 分钟
3️⃣ DeepSeek V4.1 Flash(max):14.0 分钟
4️⃣ Gemini 3.8 Flash(high):15.0 分钟
5️⃣ Claude Haiku 5.5(max):15.5 分钟
……
往后:GPT-6 Astra 16.8、Sol 19.7、Fable 5.1 23.0、Opus 5.5 26.6、Gemini 4 Carbon 29.2、Kimi K3.1 Pro 38.6 分钟。
最扎眼的对比:GPT-6 Astra 每秒只吐约 51 token,不到 Claude Opus 5.5(111 tok/s)的一半,结果平均每件任务反而快近 10 分钟干完——因为它只写 ~50K 输出 token,Opus 要写 120K–170K。
榜单真正的"快枪手"全在轻量档:Beam 1.0 只要 2.1 分钟,Nemotron 3.5 3.8 分钟,K2 Horizon 5.4 分钟。
所以"思考快"≠"干活快":单任务耗时 = 输出量 ÷ 速度。流式速度再花哨,架不住它每题多写 10 万 token。选模型的窗口期,看的从来是谁先交卷,不是谁笔速快。
源头榜单:artificialanalysis.ai/models

Google 悄悄把视频榜打穿了:新模型文生视频、图生视频双榜第一,还顺手降了 30% 的价。
Arena 官方刚更新的三张视频榜,@GoogleAI
的新模型 Gemini Omni 1.2 Flash 交出的成绩:
1️⃣ 文生视频第 1(1541 分):比上代 1.1 Flash 高 27 分,前 3 名直接被 Google Omni 系列全包了,Sora 2 Pro 只排第 13;
2️⃣ 图生视频第 1(1502 分):压过 MiniMax H3(1493)和 Seedance 2.5(1488),比自家上代暴涨 39 分;
3️⃣ 视频编辑第 3(1395 分):只输给阿里 Wan 3.0 和 Seedance 2.5,比上代高 20 分。
真正的杀招在价格——Google 官方公告白纸黑字:API 生成 720p 视频 $0.07/秒,比上一代降价 30%;单次生成时长上限从 10 秒拉到 15 秒,跳切和画面漂移都修了,还能在 Flow 里玩多轮改稿。
翻译一下:跑在最前面的模型,还顺手做了最便宜的那个。创作工具链里换模型的窗口期,往往就是这种"又强又便宜"的发布。
榜单与官方公告:
arena.ai/leaderboard/text-to…
nitter.cf/GoogleAI/status/211838…


Meet Gemini Omni 1.2 Flash ⚡️
We’ve made the model more cost-effective, bumped the video generation and editing limit up to 15 seconds, and made updates to how scenes hold together over time. We've also given character speech an upgrade, reduced visual glitches like jump cuts, and made sure the model stays even truer to any reference assets you upload.
So… what does all of that actually mean for you?
It gives you more room to tell your story. With up to 15 seconds to work with, you have more flexibility to create what you need — videos look more cinematic and smooth, offering stronger consistency that keeps objects anchored from start to finish. And when characters speak, the dialogue sounds more fluid and natural.
Creators and everyday users can start directing scenes and multi-turn edits in @FlowbyGoogle, generating 15-second clips at no additional cost in Google Vids, or creating 15-second videos in the @GeminiApp. Plus, for developers and businesses building with the API, we've dropped the price by 30% from the previous generation, making it available at just $0.07 per second for 720p video.
Watch the model in action as it turns a single style frame into a 4-shot, 15-second macro science explainer of a living beehive ↓
困扰人类 40 年的生物学未解之谜,被 Claude 几天内给摸清了!Anthropic 刚刚发布重磅突破。
细胞里有一种被称为“大教堂穹顶”的神秘巨型蛋白质桶——穹窿体(Vault Particle),质量是核糖体的 3 倍。自 1986 年被发现以来,整整 40 年人类不仅不知道它有什么用,还以为它只存在于复杂动植物体内。
Anthropic 生物计算实验室刚刚官宣:他们联手 Claude,在细菌病毒里首次找到了这种物质,并利用冷冻电镜(Cryo-EM)成功绘制出了人类首个原核生物穹窿体 3D 分子立体模型!
官方披露的几个核心细节非常硬核:
• 数月工作量缩减到几天 ➔ 过去人工测定并重构这种由 96 个蛋白拼成的大分子结构,往往需要几个月甚至几年的痛苦摸索;而在 Claude 的辅助下,关键解析只花了几天时间;
• 不到 4 个月筛完数十种候选物 ➔ 从文献大搜寻、到纯化分离算法优化、再到冷冻电镜 3D 渲染,大部分环节普通实验室接入 Claude 就能直接复现;
• 官方罕见自曝翻车 ➔ 文章里极其诚实地交代:Claude 早期自己写配方时漏算了一种添加剂,导致 DNA 无法进入细胞,整个项目硬生生被耽误了整整两周!
过去很多 AI 只是在网上做选择题刷榜,而这项研究真正向所有人证明:当大模型走进冷冻电镜和湿实验室,基础科学的进化时钟,正在被压缩百倍。
官方科研报告:anthropic.com/research/inves…
#Anthropic #Claude #生命科学 #冷冻电镜 #蛋白质设计 #AI制药 #前沿科技
DHH 亲自操刀!极客神系统 Omarchy 4.5 杀疯了:全系统 7 秒装完,原生免盘刷进苹果 Mac。
Ruby on Rails 创始人 DHH 刚正式发布了开源系统 Omarchy 4.5(代号 Quattro RS),在海外极客和 Linux 圈直接引发海啸:
1️⃣ 苹果全系 Mac 原生免盘安装:
• 彻底干掉复杂的终端命令与刻录 U 盘,在 macOS 里点开安装器,直接原生刷进 M1、M2、M3 和 MacBook Neo;
• 官方晒出真机实跑全家福,M4/M5 适配也在路上;同步推出首个 ARM ISO,支持英伟达 DGX Spark 和骁龙 PC。
2️⃣ AMD 工程师创下 7 秒装机神话:
• 全新重构的根镜像部署机制,把全系统安装时间直接砍半;AMD 工程师 Anush 现场实测,整套系统从点下到装完仅用了 7 秒!
3️⃣ 专为 AI Agent 打造的操作系统:
• 全局支持 23 种 Agent 调度(包括 Cursor、Hermes、Devin、DeepSeek、Qwen、Ollama);
• 按下快捷键 Super + ~ 随时滑出半透明悬浮控制台呼叫 AI,多账号额度打满一键自动迁移。
4️⃣ 小白也能上手的传统桌面模式:
• 告别以前纯平铺的硬核劝退,按下 Super + L 即可切换到带 Dock 栏、带标题栏的传统浮动桌面;开箱自带 50 种语言与完美的中文拼音输入法。
颜值极高、快到起飞、且深度集成 AI 的现代 Linux,手头有闲置 Mac 或轻薄本的闭眼冲。
官方发布源头:omarchy.org/news/2026/11/oma…
#Omarchy #Linux #MacBook #AppleSilicon #DHH #AIAgent #开源系统

12GB 的 RTX 3060 跑 35B 大模型狂飙 50 tok/s!连系统内存都只要 16GB。
硬件极客 @DogukanUrker 刚刚晒出了一组极度震撼的平民单卡实测:
不用 24G 显卡,就凭一张千元级 RTX 3060,把 35B 参数的 Qwen3.8-35B-A3B 跑成了飞速代码机。
硬件与参数配置:
• 显卡:NVIDIA RTX 3060(12GB 显存)
• 内存:16GB 系统内存
• 模型:Qwen3.8-35B-A3B(激活约 3B)
• 量化:Q4_K_M
• 生成速度:~50 tok/s
• 预填充速度:~550 tok/s
• 上下文上限:262K
• 推理后端:llama.cpp(Flash Attention + Q8 KV cache)
底层核心刀法:
35B 总参数但每个 token 仅激活 3B,借助 llama.cpp 把 26 层 MoE 算子卸载给 CPU 内存分担,配合 8-bit KV 缓存,把原本装不下的 35B 模型硬生生塞进了 12G 显存。
提醒一句:50 tok/s 是在日常代码和短会话下的表现,随着上下文拉长,KV 缓存仍会增加内存压力。但手头只有 3060 的同学不用换卡就能本地跑 35B 编程模型,确实把老卡榨到了极致。
源头参考 @DogukanUrker
#RTX3060 #Qwen #本地大模型 #MoE #AI编程 #llamacpp #开源技术
别再全盘单用一个模型了!Claude Code 官方隐藏的“三级混编”配置,直接把 Token 账单打骨折。
查了 Anthropic 官方文档(code.claude.com/docs/en/advi…),很多人不知道 Claude Code 官方内置了一个神级分工机制:Advisor Tool。
官方一行命令就能开启“Sonnet 动手、Haiku 跑脏活、Opus 当导师”的完全体形态:
claude --model sonnet --advisor opus
底层分工非常讲究,每一分钱都花在刀刃上:
• 主干干活(Sonnet 5.5) ➔ 坐镇主会话,负责写日常代码、修改文件、跑测试,全按便宜的 Sonnet 价格计费;
• 苦力蜂群(Haiku 5.5) ➔ 后台挂三个极速小工,并行搞定全局搜索、查找函数调用点、在独立分支跑体检;
• 战略军师(Opus 5.5) ➔ 平时全程静默不扣费!只有在重大架构定案前、同一个 Bug 反复卡死时、以及最终验收交付前,才被叫出来做最高裁决。
想在自己项目上一键配置,把这段人话直接扔给 Claude Code:
「帮我把 Claude Code 配置成 Sonnet + Opus Advisor + Haiku 蜂群:
1. 默认模型设为 Sonnet,advisorModel 设为 Opus;
2. 在 .claude/agents/ 下建立三个 Haiku 子代理:search(全库索引)、grep(查调用点)、audit(独立 worktree 审计);
3. 在 CLAUDE.md 增加规则:代码检索与审计全部分流给 Haiku 子代理。改动先出 diff 给我确认。」
既享受了 Opus 的顶级战略脑子,又全程享受 Sonnet 的白菜价。经常用 Claude 敲代码的赶紧抄作业。
官方文档源头:code.claude.com/docs/en/advi…
#ClaudeCode #Anthropic #Opus #Sonnet #AI编程 #程序员神器 #效率工具

整整 8% 的良率居然死在了一份 PDF 里。国内半导体厂让 AI 直连产线,一周逆天改命。
芯片制造界刚刚披露了一个真实的工业落地案例:
一家芯片制造厂长期遭遇良率瓶颈,设计部门和生产车间明明坐在一栋大楼里,但平时全靠一份两年前写的“静态工艺规格书(Process Spec PDF)”来回沟通。
团队尝试让大模型直接接入车间机台的底层数据流后,挖出了脱节的核心根源:
• 8% 的良率死于文档滞后 ➔ 真实车间里的光刻与刻蚀腔体分秒都在产生细微的物理漂移;设计师对着静态文档画出的合规版图,一上真机流片就报废;
• AI 在 25 分钟内动态重塑设计 ➔ 大模型不再读死文档,而是实时读取机台传感器数据,在 25 分钟内按照设备“今天此时此刻的物理精度”动态微调版图,自动规避当前机台打不准的微结构;
• 零新设备投入,一个月收回全本 ➔ 没买新机器、没加人,光靠避开漂移盲区,一周之内良率直接拉升 8%,多抠出来的良率在单月内直接赚回了全部系统部署成本。
以前大家总以为是设计与制造工艺脱节,实际上从来不是机器造不出来,而是现实中的设备分秒在变,人却一直在为两年前那份静态文档埋单。
#半导体 #芯片制造 #Anthropic #工业AI #大模型落地 #硬科技

模型权重一行没改!开发者让本地 AI 自己写代码迭代 5 天,任务成功率从 77% 狂飙到 99%。
开源项目 Claryel Autonomous(ViktorIXAI/claryel-autonomous)刚刚晒出了一份极度震撼的 5 天自主实验战报:
在一台 Mac Studio 和 B200 硬件上,基座模型完全冻结(Qwen3.8-Flash-Next IQ3_S,零微调),纯靠外部 Agent 框架自我写代码、跑测试闭环迭代了 5 天:
• 178 项复杂业务完美解决率 ➔ 从 77% 飙到了 99%(涵盖发票识别、复杂表格处理、系统诊断与编程任务);
• 整套跑分从 87 分钟砍到 6.9 分钟 ➔ 底层推理引擎由框架从 Strata 切换至 Basalt,解码吐字稳定在 130~220 tok/s,预填充提速 2 倍;
• 5 天狂吞 3700 万 Token ➔ 累计调用 3.4 万次模型,发布了 15 个自带契约测试的版本;人类作者实际等待干预仅约 35 分钟;
• 代价极其微弱 ➔ 框架平均每个任务调用 1.4 次模型,额外 Token 开销仅多花了 4.2%,却比同算力下的纯模型高出整整 13.5 个百分点。
这次实验给本地大模型指明了一个颠覆性的方向:别再死磕微调改权重了!围绕一个固定的本地开源模型,给它一套能自我写代码、找 Bug 的 Agent 框架,模型自己就能把自己迭代成满血完全体。
📎 开源仓库与方法论:github.com/ViktorIXAI/clarye…
#Qwen #AIAgent #本地大模型 #自我进化 #开源技术 #MacStudio #LLM

8.8B 小模型越级反杀!webAI 正式开源 TwIL-8B,官方模型卡数据极其炸裂。
翻完官方 Hugging Face 完整模型卡与实测大表,这只 8.8B 的端侧小钢炮把一众大模型给打懵了:
1️⃣ 同尺寸正面对决打爆对手:
• LiveCodeBench 编程狂轰 81.6 分 ➔ 直接甩开同量级霸主 Qwen3.5-9B(65.6)整整 16 分,甚至反超了大近 4 倍的 Gemma 4 31B(80.0);
• MATH-500 拿下 98.2 分,AIME 2026 拿下 88.3 分;
• 指令遵循(IFBench)拿下 74.4 分(反超 Qwen +9.9 分,甚至直接赢了 Claude Opus 4.8 的 62.2)。
2️⃣ 逼近前沿闭源旗舰 90%~93% 战力:
• 编程达 GPT-5.5 / Opus 4.8 的 93% 水平,在 13 项交叉基准中以 7 胜 6 负战胜 Qwen3.5-9B;
• 引入长度感知强化学习,解同一道 AIME 数学题,Qwen 平均要消耗 31.2k tokens,TwIL-8B 仅需 19.5k tokens,思维链开销砍掉近 40%。
3️⃣ 硬件门槛极其亲民:
• 官方直接放出了 4.98GB 的 Q4_K_M GGUF,支持 Ollama、SGLang 和 llama.cpp,普通笔记本 8G 内存就能全离线跑通。
官方也坦白了偏科边界:代码和数学竞赛极强,但百科知识类(GPQA 70.2)明显不如常规模态。专用于本地敲代码和数学符号推理,绝对是目前最凶狠的小模型。
📎 权重与模型卡:huggingface.co/webAI-Officia…
#TwIL8B #webAI #本地大模型 #开源大模型 #AI编程 #GGUF #Qwen #端侧AI

12G 显存硬啃 125B 巨型 MoE!玩家用 RTX 5070 跑 Qwen3.8 轰出 141 tok/s。
在部署框架 Strata 的 GitHub Issue #5166 里,社区玩家 AndrewDBN 晒出了一组极度硬核的单卡极限调优自测:
用一张仅 12GB 显存的 RTX 5070,配合 Strata 0.2.10,硬生生把 125B 的 Qwen3.8-Flash-Next(IQ3_XXS 极限压到 2.4 bpw)跑出了飞一般的速度:
• 9 题聚合解码 141.3 tok/s ➔ 混合基准(代码/翻译/数学)聚合值 141.3 tok/s,Agent 会话后续轮中位数 131.7 tok/s,日常短聊中位数 118.7 tok/s;4K 预填充 2,236 tok/s,16K 预填充 2,729 tok/s;
• 核心刀法:4.9G 显存专家缓存 ➔ Strata 在 12G 显存里划出 4,887 MiB(2,918 槽位)存高频专家,真实命中率高达 94.7%!95% 的专家计算直接在显存完成,配合激进的 MTP(spec=12)草稿采纳率达到 76.9%;
• 真实硬件与严格测试条件 ➔ i7-12700K + 64GB DDR4 + PCIe Gen5,CPU/GPU 均降压;测试条件为思考关闭、温度 0、单卡功耗上限 300W(原文 131W 仅为空闲读数,非推理功耗),且明确标注只测速度、未测正确性。
提醒一句:141.3 帧是 9 题聚合成绩,短聊中位数是 118.7 tok/s,192K 是配置上限而非测试深度。这是深度折腾后的极限压榨,但足见专家缓存架构把 12G 显卡逼出了多大潜力。
源头 Issue:github.com/Niko1221/Strata/i…
#RTX5070 #Qwen #Strata #本地大模型 #MoE #AI算力 #开源技术

把 Claude Code 变成 70 人的正规研发军团!Anthropic 黑客松冠军开源神器 ECC 冲破 28 万星。
很多开发者用 Claude Code 或 Cursor 写代码,最大的痛点就是“AI 单打独斗,缺少工程纪律”:一上来就瞎写、改完不测、自己给自己打满分。
曾拿下 Anthropic 官方黑客松冠军的开发者 @affaan-m,在 GitHub 全量开源了自己历经 10 个月实战打磨的工程系统——ECC(affaan-m/ECC),直接把单个 AI 扩展成了一整套工业级研发流水线:
• 71 个专门子智能体(Subagents) ➔ 包含架构规划、测试先行(TDD)、上下文隔离的代码审查员、PyTorch/CUDA 专用修 Bug 专家、以及 OWASP 安全审计员;
• 314 个即插即用技能(Skills) ➔ 覆盖 Python、Rust、Go、Next.js,连带 Docker 编排、E2E 自动化测试和 CI/CD 迁移全套规范;
• 真正的工程闭环 ➔ 严格强制 计划 ➔ 写测试 ➔ 编码 ➔ 审查 ➔ 验证 ➔ 沉淀记忆,没有失败的测试用例绝不瞎改生产代码;
• 跨工具通吃(MIT 协议) ➔ 原生支持 Claude Code,并自带 Codex、Cursor、OpenCode 和 GitHub Copilot 适配层。
友情提醒一句:别一上来无脑把 300 多个技能全开(上下文容易吃紧),先挑最核心的规划(plan)和代码审查(review)跑通,体验直接质变。
📎 开源仓库:github.com/affaan-m/ECC
官网:ecc.tools
#ClaudeCode #ECC #AIAgent #GitHub #开源项目 #Cursor #程序员神器

国产推理引擎双雄清晨大地震!SGLang 和 vLLM 刚刚同时合入两大重磅更新。
百度和月之暗面的两大模型底座,今天在底层算子和吞吐上迎来了脱胎换骨的跃升:
1️⃣ 百度 ERNIE-5.5-Flash 迎来双框架首发支持:
• 280B 巨型 MoE,每次仅激活 14B ➔ 512 个专家采用 Top-10 潜空间多路由调度,顶格 100 万(1M)超长上下文;
• 内置 ECHO 投机解码 ➔ 搭配 DSpark 草稿模型在 GB200 上数学基准(GSM8K)直接轰出 97.0%。
2️⃣ Kimi-K3.1-Pro 在英伟达 B300 上跑出恐怖吞吐:
• 93 层融合巨核一键开启 ➔ SGLang 引入 --enable-nvidia-megakernel,为 B300 专门重构了解码内核;
• 32K 深度狂飙 660 tok/s ➔ 300 个长程 Agent 高并发实测下,结合 Dflash2 投机采样,每步稳定采纳 3.68 个 Token,输出吞吐冲上 660.97 tok/s。
从 14B 极限量化激活到 660 帧吞吐,国产开源推理引擎对新架构和前沿芯片的适配速度,已经快到完全不给闭源留护城河了。
核心 PR 链接:
SGLang #48547 / #48510
vLLM #65817
#SGLang #vLLM #百度 #Kimi #DeepSeek #开源大模型 #AI算力 #B300

单月狂飙 3.5 万星!Reddit 刚评出 10 月增长最猛的 10 大 Claude 神级 Skill。
社区统计了 10 月份全球开发者给 Claude 装技能的真实 Star 增长,数据非常有意思:大家不仅在用 Claude 写代码,更在疯狂给它补齐“审美、安全审计和画架构图”的能力。
10 月霸榜前 10 的神级开源库:
1. mattpocock/skills(+35,301) ➔ 全能工程外挂,从架构重构到复杂任务编排全包:github.com/mattpocock/skills
2. DietrichGebert/ponytail(+32,647) ➔ 毒舌代码重构员,专门清洗垃圾代码与坏味道:github.com/DietrichGebert/po…
3. cloudflare/security-audit-skill(+31,357) ➔ Cloudflare 官方安全审计,自动扫描漏洞出修复 PR:github.com/cloudflare/securi…
4. pbakaus/impeccable(+24,854) ➔ 顶级前端设计外挂,治好 Claude 做界面的粗糙感:github.com/pbakaus/impeccabl…
5. wheresryan22/anatomy(+23,150) ➔ 系统解剖大师,一键拆解复杂大项目的组件链路:github.com/wheresryan22/anat…
6. cathrynlavery/diagram-design(+20,527) ➔ 专业架构图与流程图绘制,颜值极高:github.com/cathrynlavery/dia…
7. Graphify-Labs/graphify(+17,114) ➔ 把几万行代码直接做成交互式知识图谱:github.com/Graphify-Labs/gra…
8. obra/superpowers(+16,461) ➔ 赋予 Claude 终端调度的全套黑魔法超级技能:github.com/obra/superpowers
9. Leonxlnx/taste-skill(+15,216) ➔ 专门给 AI 注入现代极简审美,去掉界面 AI 塑料味:github.com/Leonxlnx/taste-sk…
10. Nutlope/hallmark(+14,052) ➔ 独立开发福音,一键规范品牌 UI 色卡与设计系统:github.com/Nutlope/hallmark
玩 Claude Code、Cursor 或各类 Agent 的同学,闭眼挑两三个装上,体验直接升维。
#Claude #ClaudeCode #GitHub #AIAgent #开源工具 #程序员神器 #独立开发

别再搞“高智商总管+廉价小工”的 Agent 组合了,越省反而越贵!
很多人以为让 Claude Opus 5.5 做规划、派活给便宜的 DeepSeek 敲代码能大幅省钱。Reddit 极客跑了 41 种编队、1200 多轮实测,结果被真金白银的账单狠狠上了一课:
• 不仅成功率暴跌,账单还变贵了 ➔ Opus 单打独斗拿下 81% 成功率,单任务 $1.20;一旦拉上 DeepSeek 组队,成功率直接跌到 67%,每任务成本反而涨到了 $1.29;测试了 41 种多模型队伍,无一例外全被单兵 Opus 吊打;
• 致命元凶:缓存超时(Prompt Cache) ➔ Opus 本身连续跑有缓存优惠,读长上下文极便宜。但把活派给小工后,小工写十几分钟代码,Opus 后台的 5 分钟缓存早就超时失效了,交接时被迫按全额天价重新读写上下文,浪费的钱直接吞掉了小工省下的那点微末碎银;
• 好策划救不了弱小工 ➔ 71% 的组队翻车,都是小工模型自己单跑也根本搞不定的难题,交接过程还容易互相脑补幻觉;
• 真正的省钱解法 ➔ 想要低成本,不如直接用单模型单打独斗,GPT-6.1 Terra 成功率 78%,单任务只要 $0.17。
以为是“高手带实习生”,实际是“高手天天在等实习生交作业,最后全按加班费重写一遍”。多 Agent 架构别瞎凑,先算清系统交接成本。
#AIAgent #Claude #Opus #DeepSeek #GPT6 #大模型成本 #PromptCache

智商正在以断崖式的速度变便宜!最新 Agent 榜单与账单对比,差距彻底看傻了。
综合 11 月 5 日更新的 Agent Arena、LiveBench、以及刚放出的 ToolSpace 论文,前沿模型的“每任务真实成本”正在暴力洗牌:
• 顶尖性能打平,价格暴降 4 倍 ➔ 在全球 Agent Arena 榜上,Opus 5.5 拿第一(20.14%),但单个任务要烧 $6.79;紧随其后的 Gemini 4 Carbon 拿下 16.72%,单个任务只要 $1.69(直接便宜 4 倍),还在投行金融和咨询项上拿下世界第一;
• DeepSeek 把成本砍到了两毛钱 ➔ LiveBench 代码榜上,开源的 DeepSeek-V4.1 Flash 跑出 96.0 分,正面战平闭源的 GPT-6.1 Sol,但单任务成本只要 $0.185(仅为顶流闭源模型的 1/40);
• 银行复杂业务正面硬刚 ➔ 今日最新论文 ToolSpace(arXiv:2611.05036)实测,DeepSeek-V4.1 在 Banking Pro 金融测试中直接打平了 Opus 5.5(35.7%)。
过去大家总以为“最贵的大模型才最聪明”,但数据不会说谎:顶尖推理能力的门槛正在被极限拉低。选型别再迷信单价最高的模型,算清 ROI 比什么都管用。
论文出处:arxiv.org/abs/2611.05036
#DeepSeek #Gemini #Claude #AIAgent #大模型成本 #LiveBench #AI评测

💀 彻底干碎几十万的动捕房!破万星开源神器 FreeMoCap:几台破手机就能玩转真人 3D 动作捕捉。
以前搞 3D 动画或游戏开发,想要精准动捕极其劝退:要么花几十万搭光学动捕房贴满反光球,要么花几万买易漂移的传感器动捕衣。
纯开源神器 FreeMoCap(10,500+ Star)直接把专业门槛打成了白菜价:
• 零穿戴标记(Markerless) ➔ 不穿动捕服、不贴反光点,随手拿 2 台旧手机或廉价 USB 摄像头多机位拍摄,算法自动从多视角像素里解算出高精度 3D 人体骨骼;
• 手势与全身姿态全捕获 ➔ 全新升级的手部检测与高精度跟踪,不仅识别人体四肢走跑跳,连手指微动作也能精准追踪;
• 2.0 迎来一键桌面端 ➔ 告别以前配 Python 环境疯狂报错的折磨,新版直接把解算引擎打包成了独立客户端,Mac(Apple Silicon)、Windows、Ubuntu 点开即用;
• 直通 Blender / 游戏引擎 ➔ 解算完成一键导出 .blend 原生工程文件与 FBX 动画,直接套进 Blender、UE5、Unity 驱动你的 3D 角色模型。
做独立游戏、3D 动画、数字人或是运动科研的同学,这套免费开源工具绝对能省下几万块设备预算。
📎 开源仓库:github.com/freemocap/freemoc…
官网:freemocap.org
#FreeMoCap #3D动画 #动作捕捉 #Blender #独立游戏 #开源软件 #UE5