
Solutions Architect, Physics PhD & musician. I build AI agent systems by day, and dive into custom Triton GPU kernels by night.
Joined June 2016
- Tweets17
- Following65
- Followers47
- Likes37


Cieszę się, że mogłem dorzucić swoją cegiełkę! Gratulacje @KinasRemek za świetny release 2.2! 🚀

Dziś wydaję silnik basal 2.2 🇵🇱 z autokalibracją - model sam uczy się na Waszych prywatnych danych 🤯
Model decyzyjny jest użyteczny tylko wtedy, gdy „90% pewności” znaczy 90% na Twoich danych. Kalibrację dostarczaną z modelami dopasowaliśmy na naszych danych. Na Twoich model może być pewny siebie inaczej, nawet gdy jest równie trafny.
Dlatego w 2.2 wprowadzam coś co pozwoli ustawić kalibrację na Twoich danych - basal-calibrate. Bierzesz oznaczone przykłady ze swojego procesu i najpierw generujesz raport. Potem narzędzie dopasowuje kalibrację i wyznacza certyfikowane progi dla Twoich lokalnych danych 🤯. Bez udostępniania danych na zewnątrz, bez trenowania. Basal sam się skalibruje.
Sprawdziłem to na nowej dziedzinie, na której model nie był trenowany. Ustawienie „1%” z dostarczonego pliku przyjęłoby automatycznie co ósmą decyzję, a 8% z nich byłoby błędnych. Po kalibracji na danych użytkownika błąd kalibracji pytań choice spadł z 0,268 do 0,083. Na twierdzeniach verify model przyjął automatycznie 54,8% przypadków bez żadnego błędu.
W tym wydaniu także:
🔸 porty FP8 (vLLM) i GGUF (llama.cpp, Ollama) dla basal-omni-1.0-mini i max,
🔸 porty MLX dla Maca z Apple Silicon: mini, max i 1.1-max,
🔸 wkłady społeczności. Dziękuję:
- Piotr Durlej (eksport GGUF) @pdurlej - super, pomogło mi zoptymalizować eksporty do GGUF
- Kuba Sołtys (Google TPU) @QoobaSol - świetna implementacja na TPU
- Michał Kardyś (AMD Strix Halo) - dziękuję bardzo bo już nie miałem możliwości by się tym zając (sprawdziłem u mnie i działa świetnie) @kardysm
- lukaspoloki (basal-viz, podgląd każdego kroku decyzji).
- Paweł Kiszczak - eksporty do AppleSilicon MLX
Podziękowania za cały weekend bardzo miłych wpisów, liczne komentarze opublikuję dzisiaj wieczorem. Ile wystarczyło czasu to odpisałem. Później już pracowałem nad kolejnymi usprawnieniami. Dzisiaj czytam kolejne wpisy. Dziękuję.
1
31
815
Full line-by-line code breakdown and benchmark results:
Code (GitHub): github.com/qooba/bielik-anat…
YouTube: youtube.com/watch?v=zklv6Opo…
34
Why is standard self-attention so slow? Because your #GPU cores are literally stuck in a massive HBM memory traffic jam.
I'll show you how to fix this bottleneck by coding #FlashAttention from scratch in #Triton.
Link in the comments! 👇

1
1
33


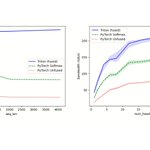
The Bielik SLM to #Triton migration continues, and this time I caught my #GPU completely slacking off during RMSNorm and Softmax. I decided to smash the "Memory Wall" with custom fused kernels and double #PyTorch's speed - JUST FUSE IT! youtube.com/watch?v=FD_xre7a…

50
FastAI with TensorRT on Jetson Nano - really fast guide.
Read more on: qooba.net/2020/05/10/fastai-…
#machinelearning #jetsonnano #fastai #docker #tensorrt
1
Homemade quantum teleportation using Q# language.
Read more on: qooba.net/2019/02/09/quantum…
#quantumcomputing #quantumteleportation #docker #qsharp
1
How to improve elasticsearch results with machine learning. Read more on: qooba.net/2018/12/01/boostin…
#docker #elasticsearch #MachineLearning
Collaborative filtering based recommendation system with #databricks read more:
qooba.net/2018/08/22/another…
1
