
Quant · AI · Market Making | Build systematic liquidity & alpha
Singapore
Joined March 2024
- Tweets649
- Following422
- Followers5.9K
- Likes1.6K


有了AI以后,开一个新项目的成本低得惊人。一个念头,一个下午就能搭出雏形。于是电脑里慢慢堆满了做到一半的东西。
起初我以为这是效率的胜利,后来才意识到,AI压缩的只是项目的一部分。
一、被加速的是前半程。搭框架、写代码、跑出第一版结果,这些AI做得又快又好。后半程几乎没有被压缩:验证它到底对不对,放进真实环境里跑,处理那些只有跑起来才会暴露的问题。计算机里有个阿姆达尔定律,说的就是这件事:一项任务只有一部分能被加速时,整体提速的上限,由不能被加速的那部分决定。假设AI把八成的工作压缩到几乎为零,剩下两成照旧,整个项目最多也只快五倍。
二、在量化里,这两成里最硬的一块是时间。一个策略成不成立,最终要靠足够长的样本外来回答,这段时间AI替你过不完。开得越快,只是让越多的想法停在"还不知道好不好"的状态。雏形带来的进展感是真实的,它携带的信息量却很少。
三、半成品并非没有成本。每个没做完的项目都像一份期权,留着它,好像保留了一种可能。但期权有时间价值的损耗,代码会过时,数据会陈旧,当初的思路会被遗忘。更隐蔽的成本在注意力上。组织行为学里有个概念叫注意力残留,人从一件事切换到另一件事时,会有一部分心思滞留在上一件事里。手上的项目越多,滞留越多,每件事分到的都只是残余的注意力。
所以,当"开始"变得廉价,稀缺的就成了"选择"。能力不再体现在能同时做多少,而在于决定不做什么。
认真夸一个人!纳米老师@antiAIvo!纳米老师伟大!!
之前写过,做研究最怕闭门造车,不知道自己站在哪。其实学 AI 也一样,资料太多,不知道先学什么、自己学到哪了。
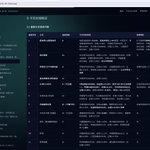
他做了一张大模型学习路线图,从 Transformer 一路到 DeepSeek-V4,8 个阶段、51 个知识点,每一项要先学什么、去哪学都标好了。很多还配了他做的图解和教程,另外开源了从零手写 GPT-2 和 Agent 的项目。
最难得的是全部免费。超级干货!有人找他付费咨询,他都是回人家不如去问 Claude!
我天天用 AI,其实不够了解 AI。还需要不断学习。大家也可以看纳米老师的内容学习!
nano-ai.tech/map

大模型学习路线图
从 Transformer 到 DeepSeek-V4,按学习顺序分成 8 个阶段、51 个知识点。每个知识点写清楚是什么、为什么重要、要学会什么、先学哪几个。
nano-ai.tech
如何从零手写一个Agent?整了一套 Agent 教程,共18 篇
Claude Code、Codex 这些编码 Agent
内核其实就是一个循环:
模型请求工具,代码执行,结果放回对话,直到模型不再请求
这套教程从100 行代码开始
用 Python 一层一层往上加:
工具、权限、上下文管理、Skills、
接入聊天软件、定时任务、MCP、子 Agent、计划、记忆。
每一课都有能直接跑的代码
每一课末尾都对照主流 Agent 在这一块是怎么做的
最后 7 篇,拿亲手写过的这 11 个零件当尺子
逐个拆解 Claude Code、Codex、Pi、Grok Bot、
DeepSeek Harness、OpenClaw 与 Hermes
看它们各自做了什么取舍
整理完最大的感受是:
主流产品的分歧,大多集中在一个问题上:
安全这一层,交给提示词,还是交给代码
namiai.tech/agent/?v=1

SK retweeted

如何从零手写一个Agent?整了一套 Agent 教程,共18 篇
Claude Code、Codex 这些编码 Agent
内核其实就是一个循环:
模型请求工具,代码执行,结果放回对话,直到模型不再请求
这套教程从100 行代码开始
用 Python 一层一层往上加:
工具、权限、上下文管理、Skills、
接入聊天软件、定时任务、MCP、子 Agent、计划、记忆。
每一课都有能直接跑的代码
每一课末尾都对照主流 Agent 在这一块是怎么做的
最后 7 篇,拿亲手写过的这 11 个零件当尺子
逐个拆解 Claude Code、Codex、Pi、Grok Bot、
DeepSeek Harness、OpenClaw 与 Hermes
看它们各自做了什么取舍
整理完最大的感受是:
主流产品的分歧,大多集中在一个问题上:
安全这一层,交给提示词,还是交给代码
namiai.tech/agent/?v=1


SK retweeted

路线一:云端 Agent 平台 - 产品逻辑是把 Agent 做成一个"云端员工":你给它任务,它在自己的一次性容器里干活,产出一个 PR。这个模型的强项是心智极简(像分派工单)和天然的规模弹性(一千个任务就是一千个容器)。边界在于:环境是私有且短命的——Agent 之间没有共享现场,两个 Agent 要协作,只能通过 Git 这个以小时为节拍的通道;环境每次重建,依赖重装、服务重启、上下文重来;人被排除在执行现场之外,只能在终点审查一个几千行的 diff。当任务需要"多只手在同一个现场接力"时,这个模型的摩擦会随协作密度平方增长。
路线二:终端 Agent - 产品逻辑是让 Agent 直接跑在开发者的机器上,用真实的项目、真实的工具链。强项是现场的真实性——Agent 看到的就是你看到的。边界在于:单人单机——两个 Agent 并行会互相踩文件;隔离缺失——Agent 的每条命令跑在你的用户权限下,它能读你的一切;可迁移性为零——你的机器合上盖子,一切停止。终端 Agent 事实上是把"共享电脑"问题的答案设成了"就用你那台",这在单人场景成立,在团队场景不成立。
路线三:沙箱基础设施 - 产品逻辑是把"安全地执行不可信代码"做成 API,卖给上层应用。强项是把 microVM 级的隔离与秒级快照做成了商品。边界在于定位本身:它们提供的是砖,不是房子——单个沙箱没有多用户身份概念,没有跨沙箱的文件共享语义,没有"命令该去哪里执行"的判断。
路线四:云开发环境 - 产品逻辑是把"配好的开发机"搬上云,按人头分配。强项是环境标准化与"任何设备打开就能写代码"。边界在于分配的粒度:每人一个私有工作区——成员之间的环境仍然是隔离的,协作照旧走 Git;Agent 在其中只是环境里的一个插件,而非一等居民;而且它们通常绑定"云端 IDE"这个交互形态,与本地终端生态有摩擦。云开发环境解决的是"我的环境"的云化。
codex宣传部部长

我认为每一个尝试自己做产品的人,都应该使用一段时间 codex,特别是交互和 UI 都交给 GPT 6 系列模型,你会受益匪浅
好处1: 你会被迫学会如何精确描述需求,GPT6 必须毛孔级指导。你瞎说一通,Claude 可能心领神会帮你完成了,但 GPT 多半会瞎做。因此你会被倒逼用更准些的描述,学习行业通用术语
好处 2: 你能学到大量的设计反例,我一直认为,学习仅要学正确的,还要学习错误的,才能理解更深刻全面。GPT 的设计,会让你知道不要做什么
好处 3: 你会变成一个有耐心、包容、不吃压力的人。你不再为一点不如意就歇斯底里,因为你已经习惯了,用 GPT 的每一天都不如意。坚持用几个月,你至少是个上忍🥷
SK retweeted

我认为每一个尝试自己做产品的人,都应该使用一段时间 codex,特别是交互和 UI 都交给 GPT 6 系列模型,你会受益匪浅
好处1: 你会被迫学会如何精确描述需求,GPT6 必须毛孔级指导。你瞎说一通,Claude 可能心领神会帮你完成了,但 GPT 多半会瞎做。因此你会被倒逼用更准些的描述,学习行业通用术语
好处 2: 你能学到大量的设计反例,我一直认为,学习仅要学正确的,还要学习错误的,才能理解更深刻全面。GPT 的设计,会让你知道不要做什么
好处 3: 你会变成一个有耐心、包容、不吃压力的人。你不再为一点不如意就歇斯底里,因为你已经习惯了,用 GPT 的每一天都不如意。坚持用几个月,你至少是个上忍🥷
今天和朋友聊天,他说套利的本来就厌恶亏损。这句话真妙。
每种策略亏钱的方式不一样。做趋势的,胜率不高,经常小亏,偶尔一次大赚把前面的都赚回来。做套利的,胜率很高,平时稳定赚小钱,但风险藏在某一次很大的亏损里。这两种分布,对人的心理要求完全相反。损失厌恶决定了你能扛住哪一种。
心理学里有个概念叫损失厌恶:亏一块钱的痛苦,大概是赚一块钱快乐的两倍。而且每个人的程度不一样。损失厌恶强的人,很难忍受趋势策略那种连续的小亏,每一笔止损都是一次折磨,往往在大行情来之前就放弃了。他们会自然被套利中性这些吸引,曲线平滑,天天在赚。
身边还有一些朋友,干什么都要对冲。我觉得他们怕的不只是亏钱,更怕“本来可以避免却没避免"的那种后悔。对冲给的不只是风险控制,还有一种心理上的确定感。
所以,是策略在选人。能长期坚持下来的多是跟自己心理结构匹配的那一种。
以前做研究,基本是自己想、自己试。想到一个因子就去回测,效果好就很兴奋,以为发现了什么。其实很多我"发现"的东西,别人十几年前就研究过了。有的早就被证明有效,有的早就被证明只是数据巧合,还有的已经被用到失效了。闭门造车最大的问题,不是慢,是我不知道自己站在哪。我以为在往前走,其实可能在别人走过的路上绕圈,还会重复踩别人已经写清楚的坑。
论文让我看到一个问题已经被研究到了哪一步,哪些方法是靠得住的,哪些结论只在特定条件下成立。站在这些基础上再往前想,才有可能想出一点真正新的东西。当然论文也不是答案。市场在变。
最开始读得很吃力。从第一页读到最后一页,公式看不懂就跳过,读完觉得好像懂了,过几天什么都不记得,更别说用上。现在我会先让 AI 帮我梳理论文结构、解释看不懂的公式、整理变量定义,这省了很多时间。学的越多,越觉得自己知道的太少。每篇论文背后,都是一个人或者一个团队花了很长时间去证明一件很小的事。
我一直觉得学术的魅力之一是学会怎么严谨地提出一个问题,再把它证明出来。
刚开始做因子的时候,我也主要看回测曲线和 IC 均值。后来踩了一些坑,慢慢会多看几件事,记录一下自己现在的理解。
一、预测力:不只看 IC 均值
看 RankIC 而不是 Pearson IC,避免被少数极端值主导。
看 ICIR,均值高但不稳定的因子,实盘体验会很差。
看 IC 衰减曲线和半衰期,它决定了调仓频率,也决定了换手和成本。
看分位数收益是否单调。IC 不错但只有头尾两组有效,说明它可能是非线性的,线性组合会浪费它。
二、纯度:它是不是别的东西换了个名字
加密市场里,大部分"新因子"本质上是 BTC beta、市值、流动性或波动率的变体。
先对这些风格做中性化,再看残差 IC 还剩多少。
再对你已有的因子库做正交化,看边际贡献。一个跟现有因子高度相关的因子,单独再好看,放进组合里也几乎没有增量。
三、显著性:你试了多少次
这是最容易被忽略的一关。
如果你试了一百个因子,挑出最好的一个,它的 t 值是被选择偏差抬高的。有一篇文献说考虑到整个学术界的数据挖掘,新因子的 t 值门槛应该提到 3 左右,而不是传统的 2。
Sharpe 也一样,要用 Deflated Sharpe Ratio,把试验次数、收益的偏度和峰度考虑进去。
回测本身的过拟合概率,可以用组合对称交叉验证(CSCV)估计 PBO。
四、验证方式:时间序列不能随便切
标签有持有期的时候,普通 K 折交叉验证会让训练集和测试集在时间上重叠,等于偷看答案。
要做 purging 和 embargo,把重叠的样本剔掉,再留一段隔离期。
五、可交易性:扣完成本还剩多少
看换手率和成本调整后的 IC,而不是毛收益。
看容量:因子信号集中在小币上的,往往纸面最漂亮,实际最做不进去。
加密市场还有一个特殊问题:幸存者偏差。下架和归零的币如果不在样本里,所有做多弱势币、做空强势币的逻辑都会被高估。
六、寿命:它会怎么死
McLean 和 Pontiff 研究过,因子在论文发表之后,收益会明显下降。公开的逻辑最终都会拥挤。
所以我会持续监控因子收益的滚动表现、和其他因子的相关性变化,以及能观察到的拥挤度。不是找一个永远有效的因子,而是知道它什么时候开始失效。