
Pinned Tweet
花了 30 -40多块钱,利用一块supermini esp32s3 的板子和1.28英寸的圆形屏幕diy了个语音助手设备
本来只是想拿它做个桌面语音玩具。
正好赶上蚂蚁百灵发布新一代 Ming-3.0 音频模型家族,一口气推出了三个模型。我干脆把它们组合起来,接进这块小板子,做了个能听、能聊、还能表达情绪的 AI 桌宠。
没想到,做出来的效果有点超出预期。
以前折腾这类 DIY 语音设备,最头疼的就是三个问题:听不准、反应慢、说话没感情。
这次三个模型刚好各司其职:
1. Ming-3.0-asr-tiny:负责听
我特意用了一堆中英混杂的芯片术语测试它,语速还故意加快。
结果识别效果相当不错。松开按键后,很快就能看到转写内容,专业词汇也没有出现太多离谱的错误。
2. Ming-3.0-audio-flash:负责聊
以前做语音助手,通常要经历语音转文字、调用大模型、再把回答转成语音,整个过程多少有些延迟。
这次接入 Audio-Flash 后,交互明显顺畅了不少。
问一句,基本不用等太久就能接上话。不只是简单回答问题,聊天时也有一定的上下文理解能力。
3. Ming-3.0-tts:负责说
这是我觉得最有意思的部分。
它不再像传统语音助手那样,从头到尾都是一个语调。
说话时会有停顿、语气变化,甚至在被我故意抬杠追问时,还能表现出类似叹气、无奈的感觉。
整套东西的硬件成本也就二十多块钱。
当然,模型调用和网络服务不算在硬件成本里,但这次最让我兴奋的不是省了多少钱,而是 AI 交互的门槛又低了一截。
以前我们总觉得,做一个像样的 AI 桌宠,需要复杂的硬件、昂贵的芯片和大量开发工作。
现在,一块 mini的ESP32s3板子、一块小圆屏,再加上合适的音频模型,就能做出一个能听懂你、接得上话,还有点情绪表达的桌面伙伴。
突然觉得,办公室里那些买回来没几天就吃灰的智能桌宠,可能真的要迎来新对手了。
这才是我喜欢 DIY 的原因:花很少的钱,把以前觉得不可能的东西变成现实。
美股这张热力图,藏着一个比大涨更值得关注的信号。
美国中期选举刚刚落幕,民主党拿下众议院和参议院,特朗普接下来两年将面对一个分裂的国会。
市场先是担忧,随后迅速反弹。
但真正有意思的是,今天的资金流向。
微软涨 6.18%,苹果涨 6.61%,亚马逊涨近 7%,谷歌涨 4.61%。几大科技巨头集体走强。
另一边,英伟达跌 1.27%,台积电跌 0.76%,特斯拉跌 2.5%,工业板块整体承压。
这不是简单的普涨,而是一次明显的资金重新定价。
民主党重新掌控国会,意味着特朗普后续的政策推进将受到更多制约。关税、财政支出、AI监管、能源政策,都可能出现新的博弈。
尤其值得关注的是AI产业链。
市场并没有抛弃AI,而是在重新审视这场投资盛宴的成本和回报。卖铲子的芯片公司、建设数据中心的企业,与真正掌握流量、云服务和商业化能力的平台巨头,正在走出不同的行情。
这让我想到一句话:
牛市里最容易赚钱的是趋势,真正决定收益的,却是趋势发生变化时,你能不能及时看懂资金在想什么。
选举改变的是政治格局,市场交易的却是未来两年的预期。
接下来,AI监管、财政政策、利率和企业盈利,可能比选举本身更值得盯紧。
华尔街从来不关心谁赢得了掌声,它只关心谁能成为下一轮行情的赢家。

这个语音聊天机器人项目来自一个网友的设计项目。
我通过嘉立创pcb打板
根据bom表购买元件手工焊接而成
外壳通过3d打印。如果有需要复刻的我可以分享下,成本
大概30-40元

花了 30 -40多块钱,利用一块supermini esp32s3 的板子和1.28英寸的圆形屏幕diy了个语音助手设备
本来只是想拿它做个桌面语音玩具。
正好赶上蚂蚁百灵发布新一代 Ming-3.0 音频模型家族,一口气推出了三个模型。我干脆把它们组合起来,接进这块小板子,做了个能听、能聊、还能表达情绪的 AI 桌宠。
没想到,做出来的效果有点超出预期。
以前折腾这类 DIY 语音设备,最头疼的就是三个问题:听不准、反应慢、说话没感情。
这次三个模型刚好各司其职:
1. Ming-3.0-asr-tiny:负责听
我特意用了一堆中英混杂的芯片术语测试它,语速还故意加快。
结果识别效果相当不错。松开按键后,很快就能看到转写内容,专业词汇也没有出现太多离谱的错误。
2. Ming-3.0-audio-flash:负责聊
以前做语音助手,通常要经历语音转文字、调用大模型、再把回答转成语音,整个过程多少有些延迟。
这次接入 Audio-Flash 后,交互明显顺畅了不少。
问一句,基本不用等太久就能接上话。不只是简单回答问题,聊天时也有一定的上下文理解能力。
3. Ming-3.0-tts:负责说
这是我觉得最有意思的部分。
它不再像传统语音助手那样,从头到尾都是一个语调。
说话时会有停顿、语气变化,甚至在被我故意抬杠追问时,还能表现出类似叹气、无奈的感觉。
整套东西的硬件成本也就二十多块钱。
当然,模型调用和网络服务不算在硬件成本里,但这次最让我兴奋的不是省了多少钱,而是 AI 交互的门槛又低了一截。
以前我们总觉得,做一个像样的 AI 桌宠,需要复杂的硬件、昂贵的芯片和大量开发工作。
现在,一块 mini的ESP32s3板子、一块小圆屏,再加上合适的音频模型,就能做出一个能听懂你、接得上话,还有点情绪表达的桌面伙伴。
突然觉得,办公室里那些买回来没几天就吃灰的智能桌宠,可能真的要迎来新对手了。
这才是我喜欢 DIY 的原因:花很少的钱,把以前觉得不可能的东西变成现实。
1. 在线体验入口:chat.ant-ling.com
- 在线体验:访问 Ling Studio Chat,
选择 Ming-3.0-audio-flash,体验音频理解与对话能力。
- API 调用:Ling Studio 提供 Ming-3.0-tts-0.5B、Ming-3.0-audio-flash 和 Ming-3.0-asr-tiny 的 API 服务,
开发者可将语音识别与语音生成接入自己的业务工作流。
看到这个“老朋友”,老 AI 玩家的 DNA 真的动了。
还记得两三年前,大家都在拿“画一只骑自行车的鹈鹕”当考题,专门用来卡死模型——那时候脚踩不到踏板、车轮多出两圈、透视全崩是常态,评论区全是截图调侃的笑声。
在当时,这几乎是所有人公认“AI 永远理解不了三维物理常识”的铁证。
可现在看 GPT-6.2 Astra 的灰度表现:不仅动起来了,甚至还能做到 360° 立体运镜与重心咬合。
技术的迷人之处就在这里,它默默把当年全网嘲讽的“技术瓶颈和笑话”,变成了今天展示底层物理肌肉的基准线。AI 真正从“二维像素拼贴”,迈进了“三维空间直觉”的时代。
抛一个问题给各位:
当年那些用来测试 AI“翻车”的经典刁钻 Prompt(比如“透明玻璃杯里的折射”、“画一只不吃草的草泥马”
还有哪一个是你觉得现在的模型依然绝对跨不过去的?在评论区留一个,咱们拿新模型一起验一验。
黑石放话:Anthropic 上市后可能拿不到投资级评级。AI 融资的定价锚,从估值换成了信用。
这不是唱衰一家公司,是融资逻辑换轨。
先说结论:AI 头部公司的融资逻辑,正从「估值叙事」切到「信用定价」。
估值看增长故事,信用看现金流和偿债能力。两套尺子,量出两种公司。
第一笔账:股权融资不产生利息,债权和可转债要还本付息。
同一家公司,股权故事讲得再大,一旦发债,评级机构只问一件事:经营性现金流能不能覆盖利息。
第二笔账:投资级与非投资级之间,是融资成本的台阶。
按公开报道,黑石的说法指向 Anthropic 上市后可能落在投资级之下。具体利差数字,以评级机构正式口径为准。
第三笔账:企业采购看的是供应商能不能活过合同期。
一家拿不到投资级评级的 AI 供应商,在三年期合同里会被采购方要求额外条款。这不是技术问题,是财务问题。
我的判断:90 天内,企业 AI 采购合同会出现供应商财务健康条款。
形式可能是评级下限、母公司担保、或按季度披露现金储备。采购方先动,供应商被动接。
对照表我按公开信息整理了一版:股权融资看估值和稀释,债权看评级和契约条款。
两栏并排,能看出同一家公司两套融资语言在打架。表放在首条回复里。
AI 融资从讲故事进入算信用,企业采购会先于资本市场反应。
你手上的 AI 供应商合同,有没有财务健康条款?评论区说你的场景,我把对照表对应那一栏贴给你。
以为 10 分钟能把 Claude Duet 调教成全能个人助理。
结果卡在第 4 步的权限弹窗前整整 1 小时。
翻遍官方文档,连个标点符号都没提。
如果你也卡在“点击允许无反应”或者“设置里根本找不到授权项”,别急着重装系统。
问题出在 macOS 底层的静默沙盒拦截机制:
别死等原生弹窗
macOS 的安全机制会直接静默拦截未签名的本地守护进程。
窗口没弹出来,不代表后台没在疯狂报错。
关键漏项:辅助功能 + 自动化双向锁
光在“辅助功能”里打勾根本没用。
必须进入“系统设置” > “隐私与安全性” > “自动化”。
手动把 Claude 对终端/系统事件的交互控制权勾选上。
终极自救指令
如果隐私列表里压根刷不出应用图标,直接开终端敲一行命令:
tccutil reset Accessibility
杀掉进程重载,才能彻底强制触发系统级的提权请求。
把完整的踩坑排查清单和两行修复代码贴在第一条评论了。
折腾个人助理的建议先 Bookmark 存一下,省下 2 小时无意义抓狂。
你配的时候卡在第几步了?
看起来很华丽,需要拿到市场去验证下

对冲基金每年花几百万买数据终端和研究系统,这10个GitHub仓库加起来,能免费搭出一套完整的AI量化交易栈。
小白也能看懂每个是干啥的:
1OpenBB
免费金融数据平台。股票价格、期权、宏观数据、基本面都能一键拉取,给后面所有工具喂数据。
github.com/OpenBB-finance/Op…
2TradingAgents
AI版“交易公司”。分析师写报告、多空研究员辩论、交易员决策、风险团队最后签字,模拟真人团队做决定。
github.com/TauricResearch/Tr…
3qlib
微软出品的AI量化研究平台。从想法探索到回测落地,用机器学习做量化研究的一整套工具。
github.com/microsoft/qlib
4RD-Agent
微软的AI研究员。自己提出新因子、写代码、跑回测,自动做研究开发,挖因子效率远超人工。
github.com/microsoft/RD-Agen…
5gs-quant
高盛量化团队维护的工具箱。专门做定价、风险计算、时间序列分析这些专业量化数学。
github.com/goldmansachs/gs-q…
6nautilus_trader
生产级交易引擎(Rust写的,又快又稳)。负责最终下单执行,先模拟再实盘都合适。
github.com/nautechsystems/na…
7Chronos
亚马逊的时间序列预测模型。不用专门训练,直接拿来预测价格接下来怎么走(零样本预测)。
github.com/amazon-science/ch…
8QuantLib
量化金融的“瑞士军刀”。期权、债券、互换等的建模、定价和风险管理都靠它。
github.com/lballabio/QuantLi…
9skfolio
组合优化工具。帮你决定每只股票买多少,控制风险和最大回撤。
github.com/skfolio/skfolio
10vectorbt
超快回测神器。可以一次性测试成千上万种策略想法(含手续费),速度极快。
github.com/polakowo/vectorbt
数据(OpenBB)→ 预测(Chronos)→ 因子研究(RD-Agent + qlib)→ 决策(TradingAgents)→ 风险定价(QuantLib + gs-quant)→ 仓位(skfolio)→ 回测(vectorbt)→ 执行(nautilus_trader)。
这套工具组合能免费搭出接近专业量化团队的流程,但不是保证赚钱的系统,实盘前务必充分测试。
Google 终于把真正的王牌亮出来了。
Gemini 4 Carbon 登上 Artificial Analysis Intelligence Index v5 榜首,得分 59,比 Argon 高出 9 分。在复杂推理、知识和科学任务上展现出更强的实力。
但比排名更值得思考的是:AI 竞争正在发生什么变化?
过去,我们比参数规模、比训练算力、比谁能生成更流畅的文字。
现在,真正的分水岭正在变成:谁能更可靠地推理,谁能解决更复杂的问题,谁能把知识转化为实际能力。
模型榜单的第一名终究会易主。
但对整个行业来说,最重要的从来不是今天谁排第一,而是 AI 能力的边界,明天又会被推到哪里。
当顶尖模型开始在复杂推理和科学任务上持续突破,我们需要思考的已经不只是「AI 能做什么」,而是「当 AI 越来越擅长解决问题,人类的价值将更多体现在哪里」。
模型的排名会不断变化,但每一次能力跃迁,都在重新定义人的竞争力。
这才是 AI 竞赛真正值得关注的地方。

刚看完 Google DeepMind 团队 47 分钟的 Genie 4 深度访谈(中文字幕版),后背发凉,更多的是兴奋。
很多人还把世界模型当成「能按键控制的 Sora/Veo」。
但真正的突破是:AI 正在从生成画面,走向生成因果律。
5 个值得关注的技术信号:
1. Gemini + Genie:AI 的左右脑
Gemini 负责理解意图、推演逻辑、驱动 NPC。
Genie 负责生成画面、物理交互与音频。
一个决定世界该发生什么,一个让世界实时发生。
2. 从看风景到真交互
世界不再只是供你漫游的地图,而是能对你的行为作出反应的环境。
打碎杯子,NPC 会转头;改变环境,世界随之变化。
核心区别:视频在生成画面,世界模型在模拟交互。
3. 为什么实时性如此重要?
世界模型不能只追求画质。
你按下按键,它就要及时响应,还要维持世界状态的一致性。
真正的挑战是:画面、延迟、逻辑,三者如何兼得?
4. 为什么不直接用代码生成游戏?
代码擅长确定性,生成模型擅长创造力。
未来可能是:
Generative Code:维持世界状态与逻辑。
Generative Pixels:创造实时视觉与动态体验。
代码搭骨架,生成模型赋予世界无限可能。
5. AI 造世界,AI 进世界
智能体可以在生成的环境中探索、执行任务、发现漏洞。
这些环境还有望用于机器人训练,让 AI 在进入真实世界前学习空间关系与动作后果。
最终形成闭环:生成世界 → 自主探索 → 评测训练 → 模型进化。
过去,我们用 if-else 编写世界规则。
未来,AI 或许能直接生成一个可交互、可演化的世界。
问题来了:世界模型成熟后,谁会先被重构?
传统游戏引擎 Unreal / Unity,还是具身机器人?
#Genie4
刚看完 Google DeepMind 团队 47 分钟的 Genie 4 深度访谈(中文字幕版),后背发凉,更多的是兴奋。
很多人还把世界模型当成「能按键控制的 Sora/Veo」。
但真正的突破是:AI 正在从生成画面,走向生成因果律。
5 个值得关注的技术信号:
1. Gemini + Genie:AI 的左右脑
Gemini 负责理解意图、推演逻辑、驱动 NPC。
Genie 负责生成画面、物理交互与音频。
一个决定世界该发生什么,一个让世界实时发生。
2. 从看风景到真交互
世界不再只是供你漫游的地图,而是能对你的行为作出反应的环境。
打碎杯子,NPC 会转头;改变环境,世界随之变化。
核心区别:视频在生成画面,世界模型在模拟交互。
3. 为什么实时性如此重要?
世界模型不能只追求画质。
你按下按键,它就要及时响应,还要维持世界状态的一致性。
真正的挑战是:画面、延迟、逻辑,三者如何兼得?
4. 为什么不直接用代码生成游戏?
代码擅长确定性,生成模型擅长创造力。
未来可能是:
Generative Code:维持世界状态与逻辑。
Generative Pixels:创造实时视觉与动态体验。
代码搭骨架,生成模型赋予世界无限可能。
5. AI 造世界,AI 进世界
智能体可以在生成的环境中探索、执行任务、发现漏洞。
这些环境还有望用于机器人训练,让 AI 在进入真实世界前学习空间关系与动作后果。
最终形成闭环:生成世界 → 自主探索 → 评测训练 → 模型进化。
过去,我们用 if-else 编写世界规则。
未来,AI 或许能直接生成一个可交互、可演化的世界。
问题来了:世界模型成熟后,谁会先被重构?
传统游戏引擎 Unreal / Unity,还是具身机器人?
#Genie4
单押一家供应商的时代过去了,不折损官方缓存率的统一
聚合网关如 ZenMux才是多模型协同的最优解,
现在每天现金 PAYG 消费满 $1,即可解锁一个盲盒

DeepSeek Harness 做网络安全研究是真的强,更重要的是基本无需破甲!!!
日常做逆向、渗透研究,Claude 是不敢用了,目前适合逆向和渗透的顶级模型只有两个——
1. GLM-5.3
2. DeepSeek V4.1 Flash 1017
为了能随时切换上述模型,我一般用的是 【ZenMux】:
1. 质量、缓存率和官方完全一致
2. 无需来回多个供应商切换
3. 国产模型持续折扣
最近 ZenMux 还有万圣节盲盒 🎃:
每天现金消费满 $1 就能开盒,单份奖励最高估算价值 $500
活动 10/31 22:00 截止,每天 22:00 刷新
入口 👉🏻 zenmux.ai/halloween

Google 正式扔出 Genie 4,世界模型这次真的要“有声有色”了。
以前的 AI 视频,只能让你看。
现在的 Genie 4,开始让你进入一个可以实时交互的世界。
这次最值得关注的,不只是画面,而是 4 个关键变化:
1. 实时键盘漫游
不再只是生成一段视频,而是可以实时操控、探索仿真世界。
2. 用文字改写环境
你可以直接改变世界中的场景与元素,让环境随着指令发生变化。
3. 原生音效 + 实时 NPC 反应
世界不再只有画面,还能通过声音和角色互动,产生更丰富的反馈。
4. Gemini 作为底层 Agent
尝试实时协调世界中的物理表现与因果逻辑,让交互不只是“看起来合理”。
如果说过去的 AI 在卷文生视频,那么 Genie 4 所代表的方向,是让 AI 从生成内容走向生成可交互的世界。
这可能意味着:
传统游戏引擎、虚拟世界构建,以及交互式内容创作,都将迎来一次深层变革。
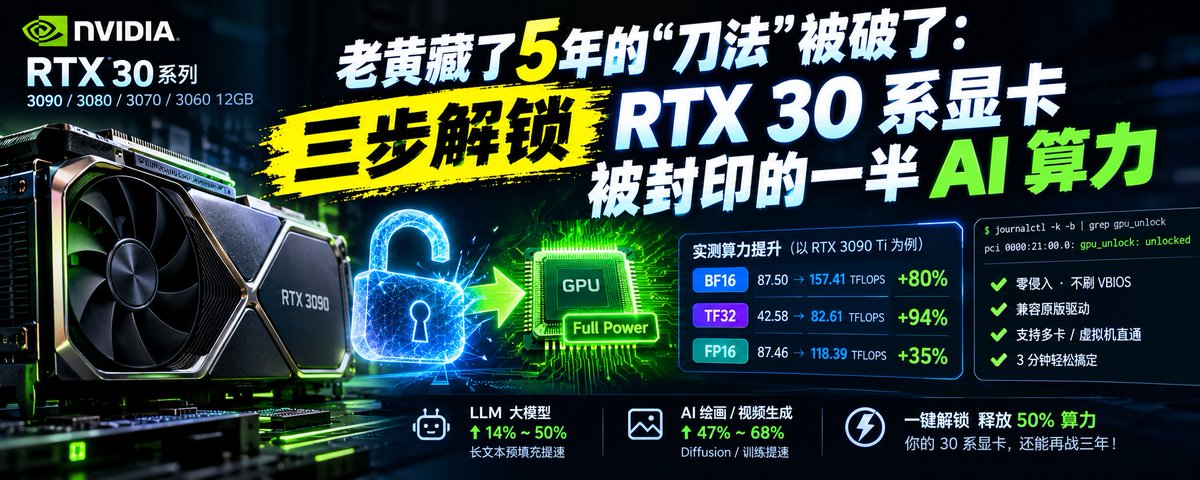
成功把手里的 RTX 3060 12GB 彻底“解封”了!
借助 gpu-unlock 突破官方限制后,直接实测矩阵乘法算力:
Dense 8192³ GEMM 算力飙升:
• BF16: 23.28 ➔ 40.37 TFLOPS (+73.4%)
• FP16: 23.28 ➔ 40.92 TFLOPS (+75.8%)
• TF32: 11.41 ➔ 20.02 TFLOPS (+75.5%)
• FP32 (对照项): 维持 7.7 TFLOPS 不变
核心亮点:
100% 位级一致 (Bit-identical):对比 CPU FP64 零精度漂移,输出 SHA-256 完美匹配。
120秒持续满载稳如老狗:4375轮迭代 0 报错 0 掉卡(峰值 91°C / 170W 满血输出)。
12GB 大显存配合满血 Tensor Core,本地跑大模型 Prefill、LoRA 微调和轻量 DiT 视频生成终于不卡算力瓶颈了!开源折腾真快乐

12G的显卡还能玩出花样来,这都开始干上Deepseek-V4.1-Flash上了

Running DeepSeek-V4.1-Flash on a 12GB RTX 5070 at over 100+ tok/s is absolutely absurd. 😭
The Strata engine’s layer-major chunked reading + GSQ-RCO quantization makes consumer MoE offloading feel completely native. Prefill is flying, and more RAM directly boosts decode speed.
Local compute is getting ridiculous. 💀