

かっこいい・美しいPC作ります!制作台数は100件以上。自作PCを応援するメディア「PCBuildnet」運営。活動目的は自作PCの魅力、楽しさを広めること。PC制作依頼はDMにて。 制作実績👉:https://nitter.cf/t.co/0JEBBtNnr2
自作PCメディア➡️
Joined March 2019
- Tweets3.7K
- Following93
- Followers796
- Likes3.9K




Pinned Tweet
こんにちは、じんと申します。
ゲーミングPC、自作PCの組み立て代行を行なっております。
◎価格
・PC制作代行:5000円+パーツ費用
・自作PC指南:3000円
◎おすすめポイント
・完全オーダーメイド
・見積もり無料
・送料無料
制作実績はXのハイライトに掲載中です!
pcbuildnet.com/job-request/
#ゲーミングPC
#自作PC

速報🚨
RTX 5090とRTX 5080が大幅値下がり!
・RTX 5090(Palit GameRock 32GB)
1,288,000円 → 1,048,000円(-24万円)
・RTX 5080(PNY ARGB OC 16GB)
359,800円 → 299,800円(-6万円)
11月に入ってから、やっと値下がり始めてました。
ただ、1年前は5090が約40万円、5080が約26万円。
ここは買いなのか...?👀


中古のグラボは避けたほうがいい。
3か月前にそう書いた私が、中古のRTX 3090を買って、案の定ハマりました🥲
3台のマザーボードで試しても、x16になりません。
私の中古の基準はこうです。
◎中古でもOK
・ケース:傷が許せるなら機能は同じ
・CPUクーラー:動けば大丈夫
◎中古は避けたい
・電源:劣化が見えない。壊れるとほかのパーツを巻き込みます
・SSD/HDD:消耗品で、寿命が読めない
・グラボ:見た目では分からない
ここまで分かっていて、買いました。
VRAM 24GBを触ってみたい好奇心には勝てなかった...!
みなさんも、分かっていたのに買ってしまったパーツ、ありますか?


せっかくお客様が送ってくれた構成表の内容を、6つも変えて見積もりを返しました。
理由は、1世代前のパーツが入っていたから。
ネットで調べて組んだ構成は、参考にした記事が少し古いだけで、今は買えないパーツやもっと良い選択肢があるケースがあります🥹
そこで、以下の内容で再提案を行いました!
◎最新の世代に更新
・CPU:i7-14700 → Ryzen 7 9700X
・マザーボード:Z790 → B850
・グラボ:RTX 4070 Ti SUPER → RTX 5070 Ti(販売終了。新しいほうが速くて安い!)
◎いまの価格と構成に合わせて調整
・メモリ:32GB → 64GB(当時は32GBが割高)
・電源:1000W → 850W
・ケース:P20C → FLUX SE(静かさを優先)
すると「どうしてもIntelが好きで」とお返事が。
それなら!と、Intelの最新世代で組み直しました。
構成が決まっていても、そのまま送ってもらって大丈夫です。
いまの世代と価格に合わせて見直します!


メモリ高騰時代にはありがたい吉報...!
Chromeさんにも何とか少食になってもらいたいところ

マイクロソフト、メモリ8GBでもWindows 11を快適に 作業速度は最大40%向上 ascii.jp/elem/000/004/449/44…

2
207
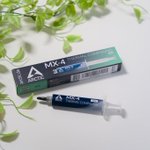
CPUクーラーに最初から塗られているグリスですが、うちではあえて拭き取って組んでいます。
その代わりに使うのはARCTICのMX-4。ご依頼で組むPCは、全部これに統一しています!
グリスは、あとから自分で塗り直す人がほとんどいない部品です。CPUクーラーを外したことがない人のほうが多いと思います。
それなら、初めから長持ちなものを使いたいですよね。MX-4はメーカーが「塗ってから最長8年」としていて、電気を通さないので、はみ出してもショートの心配がありません。
届いてから何年も、中を開けずに使ってもらうためのこだわりです!

裏配線はパネルを閉めたら見えません。
それでも、ケーブルは綺麗にまとめてから納品しています!
依頼の決め手をお客様に聞いたところ、「組み立ての綺麗さと配線のこだわりが、素人でもわかったので」と返ってきました。うれしい!
別のお客様は、納品したPCを詳しい知人に見せたら配線を褒められたと教えてくれて、2台目のご依頼につながりました。
見えないところもちゃんと見られているんですね。これからも丁寧な作業を心がけていきます💪


完成したPCなのに、ケーブルをわざと表に出したまま納品したことがあります。
「お手持ちのグラボを自分で組み込みたい」というご依頼でした。なので、必要な分だけのグラボ用電源ケーブルを、挿すだけで済む位置に簡易固定。すぐに取り付けられるように!
別のお客様は「あとからSATA SSDを自分で増設したい!」とのことでしたので、SATAケーブルを裏側に通してから納品しました。
配線は見た目だけでなく、届いたあとにご自身で調整されるパターンも考えて決めています!


34
11,123


PC制作のご相談、最初の連絡で構成まで決まっている方は、実は半分もいません。
ここ最近のご依頼案件のうち、上から20件を見てみると...
・パーツの指定なし:12件
・「初めてでよく分からない」と書いてくださった方:6件
なので、声を大にして言いたい。
『『何も決まってなくてOKです!!!』』
相談の前にパーツを勉強する必要はありません。構成を決めるのはこちらの仕事です💪
本当になんとな〜〜〜くPCが欲しい程度で大丈夫です。こちらからいくつか質問をして、そこから欲しいPC像を一緒に固めていきます。
最初にお聞きするのは、大体この3つですね。
・ご予算
・やりたいこと(遊びたいゲーム、配信、動画編集など)
・見た目の好み(参考にしたいPCの写真があれば)
「白くてかわいいPCがいい!」「このゲームを快適に遊びたい!」くらいで十分です。
見積もりは無料なので、気になったらDMで気軽に声をかけてください!

1
9
945
中古で買ったRTX 3090、手放すことにしました🥲
◎手放す理由
・3台のマザーボードで試して、x16にならず
→同じスロットに挿したGTX 1080 TiとRTX 5070 Tiはx16
・RTX 5070との2枚挿しで、冷却が間に合わず
→電力の上限を370Wに戻すと、熱による制限が209回中194回出ました
・コイル鳴きがやばい
→心配するくらいうるさい
24GBのVRAMはかなり魅力的なのは確かですが、
ハード面に問題が残ったままのRTX3090で、この先も使い続けられるかの心配が勝ちました。
とはいえ、x8のままでも生成は新品のRTX 5070 Tiより16〜21%速かったです。VRAM 24GBは、78GBのモデルを動かすうえで十分に役立ちました!
中古のグラボは、届いたら最初にリンク幅を確かめるのがおすすめです。
6年分の働き、ありがとう...!

どうやってローカルLLMを呼び出すか悩みませんか?
私は、MacのClaude Codeから自宅で動くLLMにいつでも仕事を頼めるようにしています。
構築したLLMですが、デスクトップPCなので普通は出先で使うことができません。
そこで、私は以下の体制でLLMを呼び出してみています。
◎環境・体制
・LLM:自宅のWindowsで、Qwen3.8-Flash-Next(78GB)を動かしたまま
・呼び出す側:MacBook(M4 Pro、メモリ24GB)のClaude Code
・つなぎ方:Tailscale経由のSSHで、MacからWindowsのLLMにつなぐ
・切り替え:Claude Codeの接続先だけを自宅のLLMに差し替え
・PCがスリープ中なら、Wake-on-LANで起こしてから接続
◎いつもと変わらないこと
・画面も操作も、いつものClaude Code
・CLAUDE.md、スキル、MCPもそのまま読む
・Claudeとの会話を、途中からローカルLLMに引き継げる
◎使ってみてどう?
外出先のネットワークからも、同じように使える!これが一番嬉しいポイント!
使い慣れたハーネスのまま、これまでClaudeと積み上げてきた設定もそのままで、頼む相手だけ自宅のPCに替えられるのもとてもありがたい。

RTX 3090の電力の上限を370Wに戻しても、ローカルLLMの生成は+1.3%しか伸びませんでした🥲
◎280W → 370W(ケースは閉じたまま、ケースファンはGPU温度に連動)
・実際に使えた電力: 277W → 305W
・生成の速さ: 111.3 → 112.7 tok/s
・熱による制限: 265回中4回 → 209回中194回
・3090のファン: 75% → 100%
・ホットスポットの最大: 104℃ → 108℃
上限を外しても305Wまでしか使えず、増えた分のほとんどは熱に変わってしまいました
今のレイアウトだと3090が窒息してしまうので、冷却に難があります。これだと燃えてしまうぞ🔥
電力上限はPowerShellで 「nvidia-smi -pl 280 」の1行で変えられます。
RTX 3090は、安全性の観点でも電力制限は必須っぽいです。


PCIe x8でしか認識しない我が家のRTX 3090。
それでも、新品の5070 Tiより生成が16〜21%速かったです!
◎計測(2026-10-26、同じ設定で測り比べ)
・モデル: Qwen3.8-Flash-Next IQ3_S
・RTX 5070 Ti 16GB(x16)→ RTX 3090 24GB(x8)
・短い質問の生成: 87.9 → 106.0 tok/s
・コードの生成: 104.6 → 124.5 tok/s
・長い文章の生成: 81.8 → 96.5 tok/s
◎VRAMは1.5倍、エキスパートを置ける量は2.1倍
モデルの共通部分などで、どちらのグラボも約8.4GiBを先に使います。
残りがよく使うエキスパートの置き場で、5070 Tiは7.5GiB、3090は15.6GiB。
短い質問では、使いたいエキスパートがVRAMに無かった割合が 13.4〜17.3% → 4.4〜9.5% に減りました。
◎遅くなったところ
・長い文章の読み込み: 3,231 → 2,298 tok/s(-29%)
ローカルLLMを動かすグラボは、できるだけVRAMが大きいものを!
6年前のグラボでも、VRAM 24GBの3090は、16GBの5070 Tiより生成が速かったです。
