





中野 亮太 retweeted

New Project Maya version out
v1.1.39
- DeepSeek new chat or sub agent tfft is now 19x sooner
- GLM decodes about 22% faster on PCs that read experts from the SSD: each expert goes to the GPU as it arrives.
This is amazing speed up, go ahead and update to latest.

Maya v1.1.39 is out.
DeepSeek now reuses a shared system prompt and tools across conversations, so a new chat or sub-agent gives its first token about 19x sooner.
GLM decodes about 22% faster on PCs that read experts from the SSD: each expert goes to the GPU as it arrives.
Model files you downloaded some other way can now be imported.
github.com/mw00/project-maya…

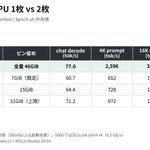
GLM5.3-Flash(ProjectMaya)でGPU1枚動作になるとどうなるのか計測してみた。
5060TiはOCuLink接続(PCIe4.0x4)なので、制限なしの接続(PCIe5.0x8)ならもう少し改善するかも?


中野 亮太 retweeted

Project Mayaの進化がとてつもなくて、DeepSeek 4.1Flash, GLM 5.3Flash, ここ数日でMinMax 3.1FlashまでもがH100やRTX6000 Proなどを用意しなくても実用的な速度で動かせるようになった
ほんの1カ月前から考えるとこんなの黒魔術にしか見えない
ソフトウェアのパワーを @PeasantSmith が教えてくれた
メモリを128GB化して出来るのがDeepSeekV4.1 1017の動作が多少早くなるぐらいで、現状は頭打ち?な予感。
ここから上の世界はVRAM(3090/4090/5080 24GBモデル?)かぁ。
Project Maya、v1.1.34でQwen3.8 Flash Next(CYBER-FROST版)がサポートされたので、早速セットアップ中。GLM5.3だとエージェント動作の遅さが気になってStrataに切り替えていただけに凄いタイミングで登場だね(しかも自分の用途にドンピシャな検証用チューニングモデルだし
github.com/mw00/project-maya

ローカルLLM+HermesAgent+ローカル仮想環境でのセキュリティチェック処理、全部まるごとGLM5.3Flash(Maya)に任せたら、あまりにも時間がかかり過ぎていたので、エージェント実行役をStrataに切り替えた。
3倍速いし、変な結果が出なければ、こっちの方が良いな(切替が遅い
中野 亮太 retweeted

GMOハッキングの件、なんか様子がおかしいんだよな。
KADOKAWAの時みたいに普通はダークウェブ上にアップするのだが、今回は普通のサーバー。
もし犯人が絶望的バカならGMOの開示請求で住所割れて逮捕。ただそんな事あり得ないので、サーバーは他人名義のものが使われてるはず。
となると、そのサーバーにアクセスして操作しているノードを逆探知のようにさかのぼる必要があるが、普通複数のノードを経由させるので追跡に時間がかかる。発信元を突き止めたとしてもそれがまた他人名義のものだと詰み。
とまあすごい金銭的コストがかかるので、個人がここまでやるとは思えず何かしら組織的な犯行、あるいはここまでしてもGMOを脅迫したい動機がある可能性が高い。
証券取引所で不審な空売りがなかったか、個人的な猛烈な恨みを有する社員が最近退職してないか、このあたりから操作の糸口が見えてきて、犯人は捕まりそうな気はしてる。(GMOに限っては)


中野 亮太 retweeted

2段階認証の機能を、noteの全クリエイターに開放しました。
これまではpro専用機能でしたが、全アカウントの基本機能になります
note.com/info/n/nd031a92f496…

中野 亮太 retweeted

Local LLM - 2026年10月のLLM
個人的なLLMの感覚
Cloud LLMs は3千円/月のチャッピーとClaude Opusでかなりのことができる。ただし『使用料と使い方、明日どうなるか?』は企業次第で保証されていない。
ローカルLLMは安さよりも主権(変わらない精度、実行タイミングの決定、固定金額)
Strataのおかげで『Qwen3.8-Flash-Nextが、ミニPC(約14万円)+OCulink経由eGPU(約11万円)で40tok/sで使える』ようになった。
Project Mayaのおかげで、GLM-5.3-Flashも約35万円の自作PCで40tok/sで使えるようになった。
DeepSeek-V4.1-Flash-1017を試すのはもう少し後にしますが、これも50万円以下のPCで使えるようになれば、遊ぶには充分な気がします😌
抜粋:DeepSeek-V4.1-Flash-1017: ふざけたモデル名であるがローカルで動くLLMとしては最強格。Strataからの流れでなぜかローカルで動くようになった。

LLM界隈の現状をまとめてみた。
Opus 5.5: 現状最強。コーディングから動画制作まで強い。SonnetやFableの良さもあるが、とりあえずOpusでいいと思う。コスパもかなりあ良い。ガチで良い。
⇒現時点で絶好調だが、Fable5.5での更なる飛躍に期待
Astra/Sol: 手堅いコーディングには定評があるが。Claude Opus 5.5に押され気味。画像生成が出来るのは強み。リセットを活用すれば物量をこなせる。Solは安い。決して悪くないのだが、現時点ではAnthropic(Claude)に押され気味。
⇒Astraの後継モデルや、Belと呼ばれるモデルに期待
Gemini 4 Argon: リリースされた。文章力はトップ。視力は良いと思われる。動画入力、音声入力などに強みがある。コーディングに使っているという話は聞かない。
Kimi K3.1 Pro: 予告通りリリースされた。強いが、コーディングは微妙との声も。Claude CodeやCodexが十分に使えるなら敢えて使う必要性を感じない。ウェイトが公開される見通しだが2.8Tはローカルでは動かせない。
Qwen 3.8 Flash next: 一般ご家庭のパソコンでなぜか動くようになったLLM。125bに51bの参照テーブルがあるのに、DRAM64GB、VRAM12GB程度でまともに動く。RTX4090だと100TPS程度で普通に速い。Opus4.6に匹敵する。
⇒Qwen 4 Flashが期待されている。
Qwen 3.8 27b: 上記のFlashNextの陰に隠れているが、VRAM16GBで動きメインメモリへの影響は小さい。Flash Nextよりはやや弱い。
⇒Qwen 4 27bが期待されている。
DeepSeek-V4.1-Flash-1017: ふざけたモデル名であるがローカルで動くLLMとしては最強格。Strataからの流れでなぜかローカルで動くようになった。Qwen3.8 Flash Nextより要求スペック高め。速度は遅め。Opus5級。ローカルLLMに入れたが、実質クラウド向け?API価格は激安です。
中野 亮太 retweeted
Local LLM - できる範囲で楽しむ
余裕がある人が高額な大容量メモリーや最新GPUを購入してテストしているのを見るのも楽しいですが、自分が無理して高額な製品を購入する必要はないと思います。
自身が無理の無い金額で購入したPC構成で性能を上げるには、その工夫をしていると学ぶことも多いし、知恵を出し合っている人の投稿を見ると勇気をもらえる、という楽しみ方もあります☺️
#地元のLLM

中野 亮太 retweeted

Two open-source engines can run DeepSeek-V4.1-Flash, a 748B model, on home GPUs.
Maya, which I build. Strata, which Niko (@coldniko) builds. Maya started as a Strata fork, and Maya's README says so.
This is how Strata's DeepSeek support started, and how its quants compare to mine. Commits, quotes, numbers, links.