

Consultor SEO y divulgador sobre IA. Dirijo @AgenciaUSEO, equipazo especializado en SEO internacional y para ecommerce. Soy un loco con dos newsletters. 😅
Madrid, Comunidad de Madrid
Joined October 2011
- Tweets37.9K
- Following1.9K
- Followers27.7K
- Likes59.7K




Pinned Tweet
🔴 La marca de agua de un LLM no es un carácter invisible que desaparece al pegar como texto plano. Explico cómo funciona realmente y si es posible eliminarla:
1. En un LLM, la marca de agua es el resultado de aplicar un patrón estadístico a la generación de tokens, que sólo el proveedor del modelo conoce realmente (y si comparte el método, como Google, mantiene secreta la clave para identificar el patrón).
2. ¿Cómo funciona?
En cada punto en el que el modelo va a generar una nueva palabra (en realidad un token), se toma una ventana del contexto que precede al nuevo token y se combina con una clave secreta. De ahí sale una semilla pseudoaleatoria, que se usa para dividir el vocabulario total en dos grupos de tokens: el grupo verde (el que queremos que nuestro modelo elija) y el grupo rojo.
Cuando no se interviene sobre la elección, cualquier token tiene una probabilidad determinada de ser el elegido, dado un contexto concreto. Esa probabilidad viene dada por el entrenamiento del modelo y su configuración interna (sus pesos y parámetros).
Lo que hacemos ahora es darle a los tokens del grupo verde un pequeño empujón, aumentando levemente sus probabilidades de ser elegidos. Y para decidir qué token va a cada grupo se usa una clave secreta, que sólo conoce el proveedor del modelo.
3. ¿Son fijos el grupo verde y rojo?
No, si lo fueran sería posible observar desde fuera qué palabras tienden a repetirse más que otras, y el lenguaje generado por ese modelo sería poco natural. Lo que se hace es que por cada contexto diferente, se genera su propio hash y su propia separación del vocabulario en tokens rojos y verdes.
Simplificando mucho: si digo “El próximo eclipse total se producirá…”, el token “en” podría estar en el grupo verde, y si digo “El próximo eclipse de totalidad tendrá lugar…“, el token “en” podría ser rojo.
4. ¿Degrada la calidad o coherencia del texto aplicar un método de este tipo?
Con una implementación más o menos sencilla como la que acabo de describir, sí, la calidad o naturalidad del texto sería ligeramente menor que si no se interviniera en la elección del token.
Pero existen métodos más complejos que hacen que, en la práctica, el sesgo sea imperceptible. Google Deepmind desarrolló y puso en open source un método llamado SynthID-Text, que le da una vuelta de tuerca al método base (llamado KGW por las siglas de sus autores).
SynthID, en lugar de dividir entre grupo verde y rojo para cada diferente contexto, aplica un método llamado “de torneo”. Se toman múltiples tokens elegidos libremente por el modelo como buenos para ese contexto (sin influir en esa elección) y se emparejan en duelos. Con una clave secreta se generan unas puntuaciones que deciden cuál de los tokens gana el duelo, repitiendo el proceso a lo largo de muchas rondas (generalmente 30).
La marca de agua es la correlación estadística que se va acumulando en el texto entre los tokens elegidos y sus puntuaciones de marca. Por aclarar: esas puntuaciones sólo pueden reconstruirse con la clave secreta que guarda Google, por eso no importa que hayan puesto el método general en open source.
5. ¿Es realmente imperceptible SynthID-Text?
Google hizo un test A/B en vivo en la app de Gemini, en el que enseñó a los usuarios respuestas con marca y sin marca. Luego analizó el feedback dado a veinte millones de estas respuestas. Conclusión: la tasa de “pulgares arriba” fue 0,01% mayor en las respuestas con marca, y la tasa de pulgares abajo, 0,02% menor. Es decir, no hay un efecto negativo apreciable al aplicar la marca de agua.
6. ¿Qué método concreto va a usar Anthropic? No lo sabemos exactamente. En su anuncio han hablado de “imperceptible”, y eso me sugiere que van a primar que se preserve la calidad del texto, tal y como hace SynthID.
7. ¿Todo esto tendría alguna efectividad en textos muy cortos?
La longitud del texto desde luego importa. A más texto, mayores posibilidades de incorporar la marca de agua de manera efectiva.
Y luego está la entropía del texto. Un texto creativo suele tener entropía alta, porque en general la probabilidad de cada posición no está altamente concentrada en unos pocos tokens, sino que se reparte de manera más equitativa entre muchas opciones. Pero no pasa lo mismo en textos de baja entropía, donde el camino hacia el próximo token está fuertemente determinado por el contexto que le precede.
8. Entonces, ¿qué pasa con el código o con textos de tipo legal?
En teoría, este tipo de textos se prestan peor a una marca de agua que los textos creativos. Pero también para esto hay una posible solución.
En código, no todas las partes del texto tienen la misma entropía. Por ello, se aprovecha para colar la marca de agua en elementos no vitales, como por ejemplo los nombres de las variables o los comentarios, en lugar de los elementos estructurales (como “for”, “in”, etc).
9. ¿Se puede eliminar la marca de agua si parafraseo el texto generado?
El clásico “espineado” de texto, un método muy usado en SEO antes de que existiesen los LLMs. Pues sí, si el parafraseado y uso de sinónimos es agresivo, podría debilitar o incluso eliminar el rastro de la marca (dependiendo de factores como el método de parafraseado y la longitud del texto).
Se ha visto que combinar “ataques” de léxico y de sintaxis puede ser efectivo. Según el CTO de GPTZero, ya hay herramientas que son capaces de saltarse SynthID.
Pero esto no quiere decir que cualquiera pueda hacerlo, o pueda hacerlo bien. El propio parafraseado necesita ser sofisticado, para no influir negativamente sobre la calidad del texto.
También es cierto que hay métodos de marca de agua más efectivos contra el parafraseo, al trabajar con embeddings (el significado latente del texto, en lugar de las palabras concretas que usas). Quizá Anthropic haya tirado por este lado, pero aún no lo sabemos.
10. ¿Compartirán los labs su detector con el público?
No lo sabemos. Es un dilema, porque si lo hacen estarían dando facilidades para romper la marca de agua, pero si no lo hacen, limitan la posibilidad de verificación independiente, que es lo que pide la UE.
Google anunció un detector, pero sólo ha dado acceso limitado a organizaciones y publicaciones. Anthropic ha prometido una API, pero creo que el acceso también estará limitado y el coste quizá sea elevado.
En definitiva, creo que veremos una carrera armamentística entre los modelos cerrados y los desarrolladores de herramientas para saltarse sus marcas.
Pero nadie puede garantizar hoy en día que tiene una herramienta que deshace la marca de agua de Anthropic, porque aún nadie ha visto cómo es esa marca.
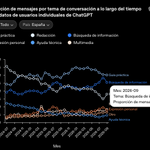
Ojo: nuevos datos oficiales de OpenAI sobre cómo y para qué usamos ChatGPT.
Un 48% del total de conversaciones son usos equivalentes al buscador tradicional (dividido entre 20% búsqueda de información y 28% guías o consejo práctico). Esto a nivel global.
En España, estos usos llegan al 55% (25% búsqueda de info y 30% guía práctica).
El segmento de edad que más usa ChatGPT para bucar información es el de 25-34 (tanto a nivel global como en España).


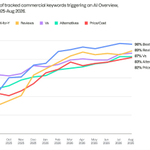
Supongo que lo habréis notado en la mayoría de proyectos este mes de octubre, pero aquí tenemos confirmación:
Más del 80% de las búsquedas en Google ya tienen AI Overviews
Eso sí, noto que también suben las búsquedas donde las AIOs aparecen por debajo de la primera posición


Si desde hace unas semanas estás viendo resultados "raros" según las herramientas de trackeo, diferentes a lo que ves en Google, no estás loco ni es un bug: es un movimiento totalmente intencionado de Google para fastidiar a los escrapeadores.
Nozzle (que es un tracker de posiciones) tiene datos precisos de cuándo se disparó esta práctica (en torno al 27-28 de septiembre), y cómo de frecuente es por país y temática.
Google ha ido introduciendo medidas para bloquear a los escrapeadores, como eliminar el parámetro num=100, obligar a tener JS habilitado para ver sus resultados, el acortador de URLs con /goto si no estás logueado, etc.
El último paso ha sido "desordenar" los resultados y meter resultados absurdos dentro de las SERPs en incógnito. Según Nozzle las búsquedas de tipo "cerca de mí" son las que más lo sufren.
Total, saben que la gran mayoría de esas búsquedas son de bots... El lado divertido es que durante unas semanas le habrán estado metiendo resultados de bajísima calidad a ChatGPT, Perplexity, etc. vía SerpAPI y demás scrapers.
Pero el lado malo, para nosotros, es que la mayoría de herramientas llevan unas semanas dándonos toda clase de falsos positivos con pérdidas de posiciones.
Así que, si ves una bajada que no te cuadra nada, antes de entrar en pánico comprueba que no sea un caso de "SERP envenenada".
Mira la SERP por ti mismo, y mira la evolución de la posición media en Search Console para esa query, por país y por dispositivo.


🛑 "No se comporte cruel o abusivamente de manera continuada e innecesaria hacia nuestros modelos"
Es la frase que acaba de añadir Anthropic en sus políticas de uso.
Por supuesto, si los modelos fuesen personas, siempre a favor de una medida así. Pero, ¿se puede ser cruel hacia algo que surge a base de multiplicar matrices con chips de silicio?
¿Quién decide que es un comportamiento cruel hacia un modelo de IA, y en caso de crueldad, estaría justificado algún tipo de sanción o pena hacia una persona?
Son cosas que, aunque ahora puedan parecer extravagantes, creo que se debatirán mucho en el futuro próximo.

Debate muy interesante por aquí. El agentic ecommerce creo que tiene mucho sentido para compras frecuentes o recurrentes: por un lado, las compras de empresas, y para particulares, las típicas compras de necesidad en una casa (básicos de limpieza y alimentación, por ejemplo).
Pero para un capricho, o algo que compras de vez en cuando y donde te puede interesar ser tú mismo el que elige el producto (moda, hogar, tecnología, hobbies) no lo veo.
Ya he dicho alguna vez que a mucha gente le gusta navegar por tiendas online para escoger su próxima compra o regalo. No creo que estén desesperados por delegar esa labor a un agente. ¿Qué opináis?

I don't think I've seen a topic as wildly, incapacitatingly, intellectually deranging as Agentic Commerce.
Note that there are no arguments here; it is taken for granted that a) "people" (who?) will want agents to buy "stuff" (what stuff?) for them and b) "they" (who?) won't want to use "some Amazon-supplied agent to do it" (why not? And how do we interpret Amazon's in incremental annualized sales in 2025 from Rufus / Alexa for Shopping then?).
This is not disciplined, logical analysis. This is faith; religious fervor. That some new technological capability becomes the dominant consumer form factor is asserted as inevitable without support.
But we know what retail platforms' incentives are: to directly manage consumer relationships so as to induce broader monetization, advertising revenue, and deeper integration (see: Amazon and Walmart commentary on the value of advertising to their businesses, Amazon's deterministic identity spine reaching 90% of US households, Walmart's acquisition of Vizio and vibe, etc.).
If all of this is stripped away: what actual opportunity exists to compete with Amazon? In other words, if the consumer relationship is competed away, what's the value of merely operating the agent <-> retailer plumbing? Sounds like a commodity with substantial operating costs if the retail platform is still expected to manage fulfillment and logistics, customer service / returns, etc.
Or will the agent do this?
Novedad de Google. Han dado a conocer el UGC Fresh Data Program, por el que plataformas con un "alto volumen de interacción y gran base de usuarios" pueden enviar directamente a Google los comentarios más recientes y sus señales de interacción.
Es independiente de la API de indexación.
Sólo pueden participar plataformas centradas en UGC, no un blog con comentarios de los lectores, aunque sea muy popular. Y la plataforma debe tener moderación activa.
Más info aquí: developers.google.com/search…


Google ha compartido un detector para verificar si una imagen, vídeo o archivo de audio contiene su marca de agua imperceptible (SynthID), lo cual verifica que ha sido generado por sus modelos de IA.
También funciona para cualquier archivo audiovisual generado por empresas partners que usan SynthID, como Nvidia, OpenAI o Kakao (Apple se unirá próximamente). Pero no sirve para verificar si se ha usado IA, cuando la imagen, vídeo o audio ha sido generado por una herramienta que no usa SynthID.
La verificación de texto (SynthID-Text) queda fuera de esta herramienta pública, y por ahora sólo tienen acceso a ella unas pocas entidades (universidades, grandes empresas de publicación, etc.)
En realidad, la verificación para imágenes, vídeo o audio generado por Google ya podía hacerse a través de la app de Gemini o en el propio buscador de Google, pero con este nuevo lanzamiento oficial le dan más alcance a la herramienta.

Podéis usar el verificador en synthid.com/

Qué buena analogía. Creo que todos lo hemos pensado: la IA te permite producir tantas cosas y tan rápido, que el nuevo cuello de botella somos nosotros mismos, revisando lo que se produce y decidiendo cómo aprovecharlo.
No veo descabellado que esto acabe creando un nuevo puesto de trabajo en equipos y empresas: una persona dedicada únicamente a revisar, comparar y sacar el máximo provecho posible a lo que crean las IAs, como los editores con el material bruto en el cine.

If you want to know who survives AI, look at what happened to Hollywood in the 1970s.
Movie Studios used to enforce tight “shooting ratios”; usually 5:1, maybe 10:1 TOPS. As in, for every 5 feet of film shot, at least 1 foot had to end up in the final cut (35mm was expensive!)
In the 70s, there was a rapid elimination of production constraints. Improvements in film cost and camera portability made the old studio rules…obsolete. Why not take multiple angles, roll simultaneously? Set could have 3, 5, even 10 cameras rolling at once. Shooting ratios *exploded*, 50:1, even 100:1 (Apocalypse Now)!
Of course, it also *radically* changed the workflow. Editing use to be the quiet, thankless job in the studio years (30s-50s). Suddenly, they became the most important people on the totem pole!
How do you find the masterpiece hiding in the (literal miles) of film? A ton of the footage was…trash, of course. But as each individual camera because *less* important, it opened up directors to take on significantly higher risks.
Now, don’t get me wrong. Insane shooting ratios were still *kinda* a niche in the 70s. More traditional directors stuck with only slightly inflated shooting ratios (15:1, 30:1 common); it was the more experimental pioneers (Coppola, Scorsese, etc) that hit the big 100:1 numbers. The huge ratios were still crazy.
Until they weren’t.
You can probably guess what happened in the early 2000s. Digital cameras reduced the cost of individual footage to a complete non-constraint. Effectively free, don’t even cut on set, just keep the camera rolling.
Suddenly…*EVERYONE* starts shooting 100:1. Entire new forms of content get created, like Reality TV, where ratios can hit 500:1! Massive shift of human labor to the editing side.
I’d say, we’re currently in the “1970s Hollywood” of AI. It can be easy (and cheap!) to produce things (code, tools, etc), but YOU have to be the ruthless editor. It’s the “miles of film” problem all over again. Hollywood solved it by throwing massively more resources on the editing side, and editing became a “constantly talking with the director about vision/direction” job, instead of a “hide in the back office and do your work” job.
It’s a hunch, but I’d bet that filmmakers closer to the experimental 1970s “ratio explosion” directors handled the later 2000s digital shift *much* better, because the underlying principles were the same. They’d certainly be ahead of the curve predicting it, and (hopefully) were less surprised when the digital ratios did hit.
I’m not saying AI is exactly the same problem. But it’s a good idea to look at parallels in history where rapid elimination of constraints changed an industry, and how that industry handled it 5, 10, even 50 years later!
When something starts to get cheap…helps to imagine what would happen when it’s free!


Que yo recuerde, Google nunca había compartido el tiempo necesarios para notar cambios concretos. Interesante que cuantifiquen no sólo recuperaciones de updates, sino cuánto tarda en materializarse en la SERP un cambio de Title o en el snippet.
Pero ojo, que Gary Illyes dijo que lo hacía para ver si la comunidad estaba de acuerdo con esos tiempos. O sea, que tampoco en nada escrito en piedra, sigue habiendo espacio para el clásico "depende"... ;)


Ojo: OpenAI también va a incluir marcas de agua en el texto generado por sus modelos.
Pero será solo en la UE (a diferencia de Anthropic y Google, que lo hacen en todo el mundo).

We're expanding our approach to content provenance to include text in response to EU regulatory requirements, while recognizing the significant limitations of current text watermarking technology.
Our tools already help verify whether an image or audio file was created with our models. This work builds on those efforts to help people better understand when content may have been generated or edited with an OpenAI model.
In the EU, we’ll start watermarking eligible text from ChatGPT and Codex over the coming weeks to comply with the EU AI Act.
Customers using our API can turn on text watermarking for select models worldwide today.
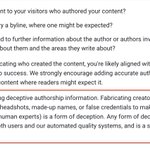
Otra novedad de la documentación de Google, sobre la autoría de la página. Antes ya había un párrafo dedicado a "quién" crea el contenido, recomendando incluir quién firma el contenido, si se trata del tipo de contenido donde los lectores esperan ver el nombre del autor.
Ahora Google añade que en ningún caso se debe engañar, ni "inventar" una identidad para atribuirle la autoría del contenido. Este tipo de engaño hará que la página sea considerada de baja calidad.
Según Google, constituye un engaño con respecto a la autoría usar nombres falsos, generar con IA fotos de personas inventadas, o exagerar o falsear las credenciales de una persona para dar la sensación de que es experto en un tema.
Todo esto ya aparecía también en la última versión de la guía para evaluadores de calidad de Google.


Update importante en la documentación de Google: su guía de Contenido Útil señala 4 atributos para considerar un contenido de calidad: Esfuerzo, Originalidad, Talento o habilidad y Exactitud (Accuracy).
La parte de Effort creo que va a dar que hablar, ya que dice específicamente "producir grandes cantidades de texto con IA generativa sin supervisión o edición manual es un ejemplo de poco o ningún esfuerzo". A buen entendedor...
La guía también especifica qué consideran contenido principal (Main Content) dentro de una página. Todo ello son conceptos que aparecen desde hace años en la guía de evaluadores de calidad de Google, pero que nunca habían aparecido como tal en la documentación pública de Search.
La documentación se actualizó el viernes 1 de octubre, coincidiendo con la sesión del evento de Search Central Live en Barcelona donde se habló de Ranking y calidad, y donde Duy Nguyen y otros googlers explicaron con diapositivas estos mismos conceptos.
La nueva página por ahora sólo está disponible en inglés, no en español. Si queréis más detalles de lo que se dijo en el evento, @NachoMascort ha publicado un post muy completo, comparándolo con la documentación, la guía de evaluadores y con conceptos y térninos extraídos de las filtraciones de 2024 y el juicio anti monopolio: nachomascort.com/blog/qualit…
Nacho destaca con acierto que la calidad no depende de la query introducida por el usuario, sino que va adherida a cada URL guardada en el index, y que en buena parte emana de una puntuación común para el sitio.
En resumen, Google aclara bastante su comunicación sobre un aspecto tradicionalmente difuso y polémico en SEO, y que muchos solían interpretar como querían.
Obviamente, Google sí tiene unos criterios para estimar la calidad de una página y de un sitio, ya que para eso estaba la guía para evaluadores de calidad.
Ahora, han sintetizado esos criterios en esta nueva versión de su documentación, para despejar dudas y porque creo que se han dado cuenta de que era poco práctico decirle a la gente "para saber qué consideramos calidad, lee nuestra guía de 200 páginas".
Recordemos que este año Google lleva ya 4 updates de Spam, lo que probablemente quiere decir que hay una enorme cantidad de contenido nuevo que no cumple para nada las directrices de spam de Google. Hacer un esfuerzo para comunicar mejor lo que piensan que es calidad y lo qué no me parece buena idea.
