SpursEngineの話してる(笑)
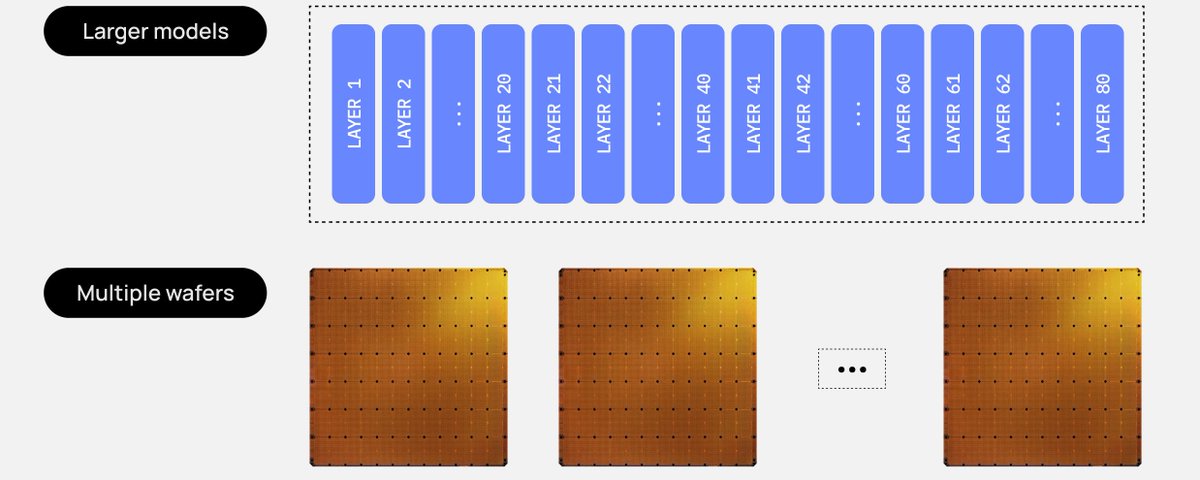
LLM推論で一押しのアクセラレータは、PFN社のL1000とd-Matrixのやつ
メモリテクノロジーが新しいのがよい
消えていったアーキもその思想は受け継がれていく

GPU UNITE Radio 新エピソード公開!
山田てるみさん(@telmin_orca)を迎えたシリーズ第2回。 AIの速さを支える技術や、アクセラレータの進化について話してます。
LLMを速く動かす工夫から、懐かしのCellの話まで。
ぜひお聴きください!
gpu-unite.ai/gpu-unite-radio…
#GPUUNITE

山田てるみさん!
GPU UNITE Radio 新エピソード公開!
山田てるみさん(@telmin_orca)を迎えたシリーズ第2回。 AIの速さを支える技術や、アクセラレータの進化について話してます。
LLMを速く動かす工夫から、懐かしのCellの話まで。
ぜひお聴きください!
gpu-unite.ai/gpu-unite-radio…
#GPUUNITE
t3840 retweeted
Patrick Stewart, ‘Star Trek’ captain and ‘X-Men’ superhero, had died at 86.
Stewart died Wednesday at his home in Los Angeles, a rep announced.
hollywoodreporter.com/movies…

時代だなぁ

AI agents are becoming an integral part of FPGA development, helping engineers tackle complex designs faster.
Altera is accelerating this shift with QuartusIQ, optimized to run on NVIDIA DGX Station for Windows, bringing FPGA-specific AI intelligence and accelerated computing together.
With NVIDIA Nemotron models running locally, QuartusIQ helps engineers create, debug, validate, and close timing in Quartus Prime Pro while keeping sensitive design data and IP within their environment.
Discover how Altera is advancing AI-powered FPGA development: altera.com/products/software…
For more on running AI locally with NVIDIA, read the NVIDIA blog: blogs.nvidia.com/blog/local-…
#QuartusIQ #NVIDIADGX #FPGA #AI