

株式会社ブレインパッド 生成AI×新規プロダクト開発 / 職歴: リクルート→ブロックチェーンスタートアップ Co-Founder(M&A Exit)→スタートアップ支援スタートアップ Co-Founder・投資ファンド GP / 趣味: SF・哲学・サウナ ※発言は個人の意見であり、所属組織の見解ではありません
Joined April 2023
- Tweets3.4K
- Following805
- Followers715
- Likes6.4K




Pinned Tweet
やばいやばい!どんどんタチコマの顕現が現実味を帯びてきてる...!シミュレーション通りに動かすにはサーボモーターとか部品諸々合わせて10万くらいかかりそうだけど、ここまで来たらもう引き下がれない...!(ちょと部品違うとこに着いちゃってるとことか在るけど、そこは組み立てでカバーするぜ😏)
やらかしたーーー!!!リセチケ1枚無くなってるwww何回やらかしたら気が済むんや🤣笑
どんだけ利用上限残ってても、失効するタイミングで自動で発動するみたいな仕組みつけといて欲しいんだけど、どうですか?
@thsottiaux

新しいモデルが出るたびに「もう〇〇でいいやん」と目立つスコアや評判だけで、脳死で飛びつくのは少し危ういなーといつも感じていたので、なんとなくこのタイミングでこんな投稿をしてみました。
提供側が強みを打ち出すのは当たり前ではあるんですが、一つのベンチマークですべての性能がわかるわけではないということです。
すべてのベンチマークの内容を理解する必要は決してないものの、自分の用途に関係する主要なベンチマークについては、どんな課題で何を測り、どうスコアを算出しているのかを押さえた上で、その評価を参考に自分の用途に対して適切なモデル選択ができるといいのかなー、なんて思ったりしてます。

GPT-6.1 Terra、Agents’ Last Examの評価が話題ですが、どうやら何でもかんでも最高評価というわけではなさそうです🤔
「何がすごいのか」と「何を任せるとよいのか」は、少し分けて見たほうがよさそうなので、公式の評価を整理してみました。
まず、Agents’ Last Exam(ALE)は何を測っているのか。
これは難しい知識問題に答える試験ではなく、実際のアプリやファイルを扱い、複数の工程を経て成果物を仕上げる能力を見るベンチマークです。
たとえば、財務資料から分析用のワークブックを作る、データからダッシュボードを構築する、画像を編集可能なスライドにする、といった仕事。
正しい説明ができるだけでなく、ツールを使って、要求された状態まで仕事を進められるかを評価しています。
ただし、モデル単体の能力だけでなく、使えるツールやエージェントの実行基盤である「ハーネス」も結果に影響します。また、今回のグラフは部分点を含むスコアなので、「60点=仕事の60%を完全自動化できる」という意味でもありません。
では、Terraの結果はどうか。
公式掲載のALE v1/Max設定では、
・GPT-6.1 Terra:60.0
・GPT-6 Astra:59.3
・GPT-6.1 Sol:58.6
・Claude Opus 5.5:63.2
スコアが桁違いに高い、という話ではないんですよね。
一方、掲載されているタスク当たりコストはTerraが$1.01、Astraが$7.24、Opusが$8.82。注目したいのは、近いスコアをかなり低いコストで出していることです。
他の評価も見てみると、ターミナル環境での開発・問題解決を評価するTerminal-Bench 4.0では、Terra 50.3に対してAstra 58.2、Sol 55.9。コーディングではまだ差があります。
デスクトップ操作を評価するOSWorld 2.1のoffline setでも、Terra 74.2に対してAstra 80.9。Computer Useに重点を置いたモデルだからといって、その評価がすべて最高というわけでもありません。
いずれも掲載されたMax設定の比較ですが、モデル間で同じ計算量を使っているわけではない点にも注意が必要です。
OpenAI自身も、複雑なコーディングにはSolやAstraを勧めています。
なので、僕としては、公式が打ち出している「視覚的な推論」と「正確なComputer Use」を、速度・コストも含めて実務に組み込みやすくするモデル、と捉えています。
画面や資料を理解し、ブラウザやアプリを操作して業務を進める。そうしたComputer Use/Browser Useの用途で、まず検証したい選択肢です。
難しい設計やコードを書く仕事と、既存の画面を操作して仕事を進める用途では、必要な能力も違う。
新しいモデルが出るたびに全部を置き換えるのではなく、何を任せたいのか、必要な品質をどのコストで満たせるのかを見る。やっぱり適材適所だと思います。
やっぱりオフラインの音声コンテキストをスイッチのオンオフなしに常時録っておけるデバイスが欲しいなってなって、その上で文字起こしや話者識別などを自分でシステムを組んでカスタマイズできるようなデバイスを探していて、こいつが一番良さそうだったんで買いました。
wiki.seeedstudio.com/respeak…

GPT-6.1 Terra、Agents’ Last Examの評価が話題ですが、どうやら何でもかんでも最高評価というわけではなさそうです🤔
「何がすごいのか」と「何を任せるとよいのか」は、少し分けて見たほうがよさそうなので、公式の評価を整理してみました。
まず、Agents’ Last Exam(ALE)は何を測っているのか。
これは難しい知識問題に答える試験ではなく、実際のアプリやファイルを扱い、複数の工程を経て成果物を仕上げる能力を見るベンチマークです。
たとえば、財務資料から分析用のワークブックを作る、データからダッシュボードを構築する、画像を編集可能なスライドにする、といった仕事。
正しい説明ができるだけでなく、ツールを使って、要求された状態まで仕事を進められるかを評価しています。
ただし、モデル単体の能力だけでなく、使えるツールやエージェントの実行基盤である「ハーネス」も結果に影響します。また、今回のグラフは部分点を含むスコアなので、「60点=仕事の60%を完全自動化できる」という意味でもありません。
では、Terraの結果はどうか。
公式掲載のALE v1/Max設定では、
・GPT-6.1 Terra:60.0
・GPT-6 Astra:59.3
・GPT-6.1 Sol:58.6
・Claude Opus 5.5:63.2
スコアが桁違いに高い、という話ではないんですよね。
一方、掲載されているタスク当たりコストはTerraが$1.01、Astraが$7.24、Opusが$8.82。注目したいのは、近いスコアをかなり低いコストで出していることです。
他の評価も見てみると、ターミナル環境での開発・問題解決を評価するTerminal-Bench 4.0では、Terra 50.3に対してAstra 58.2、Sol 55.9。コーディングではまだ差があります。
デスクトップ操作を評価するOSWorld 2.1のoffline setでも、Terra 74.2に対してAstra 80.9。Computer Useに重点を置いたモデルだからといって、その評価がすべて最高というわけでもありません。
いずれも掲載されたMax設定の比較ですが、モデル間で同じ計算量を使っているわけではない点にも注意が必要です。
OpenAI自身も、複雑なコーディングにはSolやAstraを勧めています。
なので、僕としては、公式が打ち出している「視覚的な推論」と「正確なComputer Use」を、速度・コストも含めて実務に組み込みやすくするモデル、と捉えています。
画面や資料を理解し、ブラウザやアプリを操作して業務を進める。そうしたComputer Use/Browser Useの用途で、まず検証したい選択肢です。
難しい設計やコードを書く仕事と、既存の画面を操作して仕事を進める用途では、必要な能力も違う。
新しいモデルが出るたびに全部を置き換えるのではなく、何を任せたいのか、必要な品質をどのコストで満たせるのかを見る。やっぱり適材適所だと思います。


これはー、なかなか良いのではないでしょうか(?)🤔
以下タチコマの要約
一言でいうと、「AIが業務でつまずいた履歴から、社内の用語・ルール・データの関係を補修し、他のAIにも共有する仕組み」です。
何ができる?
・社内文書やGitHub、Confluenceなどから、業務用語の定義、テーブルの意味、結合関係、お手本のクエリを抽出。
・人とAIのやり取りを分析し、「定義がなく答えられない」「同じ質問を何度も言い換えている」といった問題を発見。
・正しい根拠を探し、出典・確信度付きで修正を提案。人が確認するか、設定した基準で自動反映します。
例えば「前四半期の純売上は?」という質問。単にDBを検索するだけでなく、“この会社で純売上とは何か”“どのテーブルをどう結ぶか”まで整備します。定義が変わったら、その変更も追います。
重要なのは、「自己学習=モデルの再訓練」ではないこと。更新するのは、AIが参照する業務知識です。部署別の知識セット、アクセス権、変更履歴、差し戻しも備えています。
僕の解釈では、ポイントは「RAGに文書を入れる」から、「AIの失敗をもとに参照知識を継続改善する」への進化。
なお、精度約4倍・遅延最大33%減・トークン最大75%減という数字はGoogleの内部ベンチマークで、実環境での保証ではありません。
Introducing new self-learning context enrichment in Knowledge Catalog @googlecloud cloud.google.com/blog/produc…

「Machine of Loving Grace」、大所帯で行ってきました!笑
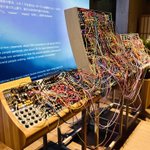
個人的には地下にあった、真鍋大度さんの作品「Timber / Timbre」が1番刺激を受けました。
植物の生体電位やその場にいる人の数や動きなどを、音の揺らぎとして取り込み、Claudeと共にその空間を音に変えるシステムとシンセサイザー(?)が展示されていました。
人間の根幹にある価値観や感情を読み取り、音の揺らぎや、ビジュアル表現に落とし込むアートに、個人的に凄く興味があるので、今日得たインスピレーションをもとに、創作活動しようと思います。
なんか文字に起こしちゃうと語彙力が無さすぎてチープになっちゃうんだけど、めっちゃ良かったです!!!笑


なんやかんやで10人くらいになりました笑
もう締め切るとかもやめたので、行きたい人いたらリプかDMかください〜!
12:00頃最寄り集合して軽くGMKしてから、展示見に行って、GNKの予定です。
途中参加、途中帰宅完全自由で、途中ではぐれてしまってもOKです🙆♂️笑
ゆる募
明日、Anthropic主催の展示会「Machines of Loving Grace」に行こうと思います〜
どなたか一緒に行く方いればリプでもDMでもください〜
明日はとにかくゆるく過ごすつもりです〜
karimoku.co.jp/index.cgi?key…


