

Founder @ Irish AI startup (seed) Sharing AI opportunities & growth 爱尔兰AI创业者,分享AI商机与增长,蓝V必回关 Building https://nitter.cf/t.co/HUFt5GLKd4 in public Follow back all verified
Ireland
Joined March 2012
- Tweets8.8K
- Following904
- Followers1.4K
- Likes22.1K




Wyong retweeted

Jev还是强,论质量暴打主流开源方案,论速度也不输,我做了个动态演示👇

Jev 发布才 8 天,开源替身已经一堆了,今天诺基亚也来蹭热闹了😅
我在 MacBook 上,让官方 Jev 和 3 个开源方案同跑 20 张中文工单🫱
Laya 25ms,比 Jev 快 50 倍
djev 509ms
官方 Jev 1.3 秒
AnyJev 将近 4 秒
仓库都在这:
Laya(Mac 版)github.com/mizorewww/laya-ml…
djev(Mac 版)github.com/jamescorbett/mlx-…
AnyJev github.com/nokia-applied-res…
但快的,不一定对 👇
Wyong retweeted

If you’re trying to earn visibility in AI-generated search results, here’s where to start: our 6-month playbook template 👇
social.semrush.com/4xIL0t8.

Wyong retweeted

100 万+行代码,从 Zig 迁移到 Rust,Anthropic 把背后的 Claude Code 方法开源了。
项目叫 code-migration-kit-with-claude-code。
这套方法参考了真实生产迁移,包括 Bun 的 1M+ 行 Zig→Rust 项目。
它不是让 Claude Code 一口气把整个仓库翻译完,而是把迁移拆成 6 个阶段:
建依赖图和迁移规则
用难文件先压力测试规则
并行翻译全部代码
统一编译,把错误变成修复队列
跑最小端到端测试
和旧实现逐项做行为一致性验证
其中一条规则很关键:
只要两个 Agent 可能给出不同答案,就先写进 RULEBOOK.md。
真正开始迁移后,每个单元也不是交给一个 Agent 就结束,而是:
Implementer + 2 个 adversarial reviewer + fixer
先翻译,两个独立 Reviewer 找问题,再让 fixer 修。
编译也不是几十个 Agent 各跑各的。
整个仓库统一做 survey build,把错误整理成机器可读队列,再按模块分给 fixer。
验证阶段更重要。
如果原来的测试不能直接复用,就要在迁移开始前建立 parity harness,同时运行旧代码和新代码,对比行为。
README 里有句话说得很直接:
No judge, no exit condition.
另外,大规模迁移的成本也不能忽略。
官方提醒,生产级迁移可能在两周内消耗 数十亿 input tokens,预算应该直接按:
工作单元数量 × 单元成本
来算。
这套流程比较适合 Zig→Rust、Python→Go、C/C++→Rust 这种整个代码库都要换语言的项目。
JavaScript→TypeScript 这种可以渐进迁移的场景,Anthropic 自己都说多数情况下没必要搞这么重。
我觉得这个项目最值得看的不是那几个 Prompt,而是怎么让一群 Claude Code 同时改大型代码库,还能保证最后的结果可验证。
Agent 可以并行,规则和验收标准必须先统一。
GitHub:github.com/anthropics/code-m…
#ClaudeCode #Anthropic #Agent #OpenSource


Wyong retweeted

我觉得中国人未来十年最大的搞钱红利之一,不是“把货卖出去”。
是把中国人的效率卖出去。
很多海外小公司有个非常大的痛点:
当地一个设计师很贵,一个运营很贵,一个客服很贵,一个视频剪辑也很贵。
但中国已经训练出了全球最恐怖的一批电商运营、短视频剪辑、供应链管理、直播、客服、AI自动化人才。
以前我们把一件19.9元的东西卖到国外。
下一阶段完全可以卖:
“中国团队帮你运营TikTok。”
“中国团队帮你每天生产20条广告素材。”
“中国团队帮你管理中国供应链。”
“中国团队帮你搭一套AI客服。”
货的毛利可能只有20%。
服务的毛利,没有集装箱。
很多人天天说中国制造出海。
我更看好另一件事:
中国人的商业效率出海。
这个市场可能比很多人想象得大得多。
Wyong retweeted

すごい。
JevでSEO内部リンク解析ツールを作ったのですが、想像以上に精度が高かったです。
100記事の内部リンク解析で、かかった費用は78円。
サイトURLを入れるだけで
・全記事の本文と既存リンクを取得
・「この記事からこの記事へリンクすべき」を提案
・リンクを入れる具体的な文章を特定
・実際に使うアンカーテキストも提示
・現在と改善後の内部リンク構造を可視化
・結果をExcelやCSVでダウンロード
まで自動でやってくれます。
実際に結果を見ると、「そこそこ!」という箇所へ内部リンクを提案してくれていました。
※大好きなCocoonさんのサイト拝見しました
仕組みはこんな感じ↓
・robots.txtやサイトマップから記事URLを自動収集
・各記事のtitle、H1〜H3、本文、既存内部リンクを抽出
・TF-IDFと類似度計算で、関連性が高い記事の組み合わせを事前に絞り込み
・リンク先ごとに、リンク元記事内の関連性が高い文章を抽出
・本文内に実在する語句からアンカー候補を作成
・Jevが「本当にリンクすべきか」をYes/Noで判定
・Jevが設置箇所、アンカー、リンクの役割を選択
・推奨確率と確信度が基準以上の候補だけを採用
・既存リンクと追加候補をマッピングして可視化
すべての記事同士をJevに総当たりさせるのではなく、通常のコードで候補を絞り、意味を理解しないと決められない部分だけをJevに任せています。
Jevは文章生成よりも、大量の判断や分類が得意なので、内部リンク分析とかなり相性がよさそうです。
使ってみたい人いますか?
思ったよりお金もかからなかったので、ニーズが高ければどこかで無料公開しようと思います。


Wyong retweeted

Stripe Atlas 注册美国公司,$500 → $250 🔥
芝加哥大学专属优惠链接,直接省 $250。
有计划注册美国公司的,可以看看:
👉 dashboard.stripe.com/registe…

如何低成本注册一家美国公司?
#独立开发者 进行到一定阶段,不得不注册一家境外公司进行 Stripe 全球收款。
可选项有英国公司、香港公司、美国公司
这个thread 主要介绍如何使用 Stripe Atlas 低成本注册一家美国公司。
Wyong retweeted

现在做 SEO 类 SaaS 早没戏了,Ahrefs、Semrush 稳坐头部,加上 Google AI Overviews 和 ChatGPT 搜索爆发,传统关键词流量断崖式下跌。
真的是这样吗?最近看到一个逆势增长的工具「Nuwtonic」,踩着 GEO 和 Agentic SEO 的风口,短时间内月访问量飙升 10 倍。
它把传统工具里最折磨用户的痛点做成了交付闭环,其中有 3 点产品策略值得参考:
1️⃣ 能落地:从报告诊断推进到代码级执行与回滚
Nuwtonic 不仅给缺 Alt 标签、Schema 混乱、有 404的体检报告,还让产品直接深入到执行层面。
· 推出「Universal JavaScript」无侵入式接入,不管是自研框架或WordPress、Shopify、Ghost 等常见 CMS,贴一行代码就能由云端 Agent 动态注入优化后的元数据和结构化数据。
· 做到URL 级版本回滚,改动不达预期可一键撤回,解决用户对AI 自动化搞崩生产页面的顾虑。
2️⃣ 可量化:锚定 GEO 刚需,把AI 引用拆解为确定性指标
Nuwtonic 把主战场搬到 ChatGPT、Claude、Perplexity、Grok 和 Google AI Overviews 的问答源头,将大模型的采纳机制拆解为具体的前端工程指标。
· 提炼高引用密度文本。专门审查页面是否具备直接回答核心问题的精炼陈述,消除无效套话。
· 补齐事实密度与 Schema 实体。让大模型在检索增强(RAG)和知识图谱对齐时,能抓取到数据锚点与权威信号,把被动等待收录变成主动的大模型语义卡位。
3️⃣ 易决策:降维 GSC 数据,用看板重构工作流
面对 Google Search Console 动辄几十万行的点击和曝光报表,Nuwtonic 的解法是把数据分析沉淀为可视化看板系统。
· 自动拉通历史数据,识别流量衰减页面和同站多页面抢同一个关键词、互相削弱的问题。
· 将专家级诊断,拆解为 30 天按周任务卡(第 1 周重构定价页直接答案、第 2 周填补竞品词缺口、第 3 周沉淀主题权威文章...)。 把过去需要 SEO 顾问花数周才能理清的执行策略,封装成立即可执行的工作流。
做这种红海垂类工具 SaaS,不要拿着用了十几年的指标去跟巨头拼爬虫体量。新站只要能把「诊断」推进到「执行交付」、把「传统排名」升维为「AI 引用占位」,红海赛道里也能撕开一道口子。
Wyong retweeted

Jev 优质案例 + 1
Cua @trycua 发布 jev-use,把「Fast Computer Use」拆成两层架构:Jev (typesafeai) 负责决策判断,Cua Driver 负责看和做。
架构:为什么拆成两层 ?
传统 Computer Use 是「一个大模型端到端包办感知 + 决策 + 执行」,慢且贵。jev-use 的做法是职责分离:
· Cua Driver:跨平台观察(截屏、无障碍树 AX、DOM)与执行,并负责执行后的状态验证;
· Jev:轻量快速的决策层,只做一件事,从候选动作里选一个;
· Cua Perception(新增,可选):当 AX/DOM 信息不足时,才调用 OmniParser 之类的截屏解析器,产出带类型的视觉区域。
五步动作循环(观察 → 按需解析 → 客户端构建候选 → Jev 选一个 ID → Driver 执行并验证)是这套架构的精髓:把「开放式生成」收敛为「有界选择」。候选动作由客户端确定性生成、带 ID,Jev 只需选择而非生成,这既压低了延迟和成本,也让循环可验证、可复现。
Cua 实测 2048 游戏 Jev 比 Astra 快 5 倍、便宜约 1000 倍(44.9 秒 / 约 $0.00108 对 294.9 秒 / 约 $1.45)。2048 是键盘中、状态完全可观察的理想任务,恰好最大化了「小决策层 + 确定性执行」架构的优势;换成开放网页任务或 AX 稀缺的场景,差距未必如此。
Computer Use 的瓶颈正从「能不能做到」转向「够不够快、够不够便宜」。Cua 的判断是用确定性基础设施(观察、候选生成、执行验证)包住一个极小的模型决策点,从而把单位任务成本压到厘级。同时 Driver 保持模型和解析器无关,意味着 Jev、OmniParser 都是可替换件,Cua 卖的是底座,不是模型。


1/ Fast Computer Use is now solved with @typesafeai Jev + Cua Driver.
Available in development preview for macOS, Windows, and Linux. We call it jev-use.
Draft #3943: github.com/trycua/cua

Wyong retweeted

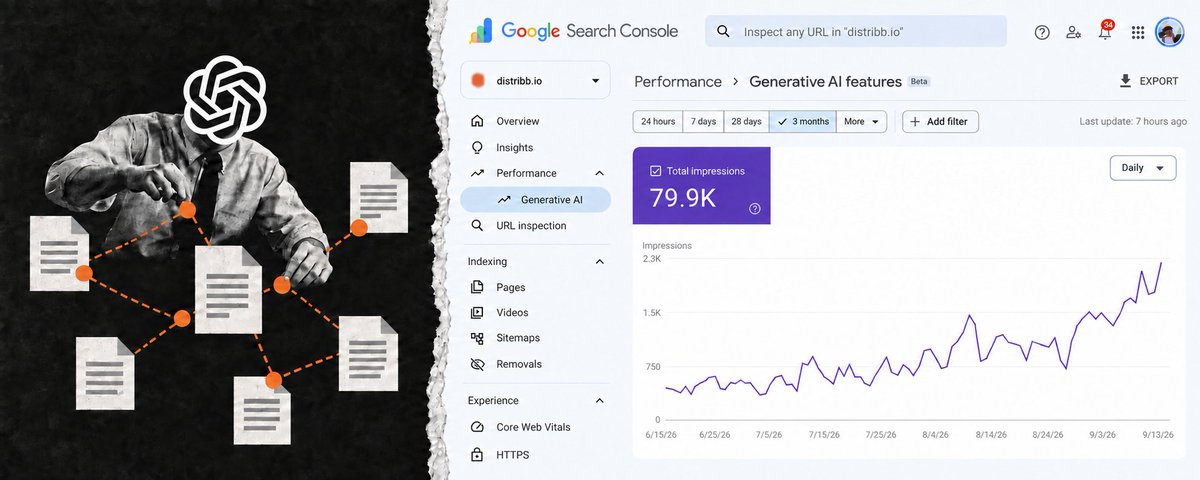
Jev is WILD for SEO audit 🤯
in 45.1 seconds it read all 586 pages on my site and rebuilt the internal link map. 584 links placed, 139 pages it refused to link because nothing honestly fit. total cost $0.21.
Claude Opus 5, same 586 pages, same clock, got through 21 of them and spent $1.43.
per page that is ~190x cheaper. the full Opus pass would have run $43.
internal linking is the perfect Jev job. it is not writing, it is 8,790 yes/no calls: does this page have a real reason to link to that one, and is there anchor text already sitting in the copy. that is a classification problem, and we have been paying frontier prices to do it one page at a time.
what you are watching: left column is Jev, right is Opus, same queue, same rubric. the run stops the moment Jev finishes so Opus stops burning tokens.
coming soon to @distribb_io + connector + gpt plugin

Wyong retweeted

这也太夸张了吧!学到了!!
这拿来做竞品分析,简直有如神助!!
37 个品牌、724 支广告,40 秒拆完!
跑完一轮分析,成本0.09美元!!
做竞品分析的朋友,看到这个真的很难不心动。
Jev 批量分析竞品广告,系统拆解背后的思路,从开头怎么吸引人,到最后怎么促成行动,覆盖六个维度:
Hook:第一句话、第一个画面,靠什么让人停下来?Format:用了什么广告形式,怎么呈现产品和卖点?
Offer:给了什么购买理由,优惠、试用,还是其他?
CTA:希望用户点击、注册,还是直接下单?
认知阶段:这条广告面向谁?
落地页:广告的落地页是否正常连接?
我知道AI可以用来研究竞品,没想到能研究的这么快,这么透彻啊!
对于前期收集素材、整理套路、寻找测试方向,这已经足够了!
Wyong retweeted

github.com/TheoLeeCJ/openjev
世の中の動向は早いなあ


Wyong retweeted

😧天呐!AI 真的在链上每 300ms 自己下单了 !
@jarrodwatts 用 Jev 搭了个交易机器人:盯盘 → 决策 → 真实成交,全在同一个 Monad 区块里完成。
Jev 关键亮点:
• System One 模型:不写字、不聊天,直接吐带校准概率的「买 / 卖」
• 延迟 70–500ms,比前沿 LLM 快 40–200 倍
• 输入 $0.042 / 百万 token,输出免费
• 架构上不可能幻觉、不可能出类型错误
• 一小时推理成本约 $0.2,比 Gas 还便宜
• 每 300ms 在 Kuru 挂真实限价单,吃价差而不是付价差
Demo:jev-trader.vercel.app/
开源:github.com/jarrodwatts/jev-t…
高速链 × 决策专用模型,交易机器人终于不用等 LLM 吐字了。
#Jev #Monad #TypeSafeAI #SystemOne #AITrading #Kuru #OnChainOrderbook
nitter.cf/nft_chen/status/210023…

🤯Jev模型游戏实测太离谱了,直接把“实时决策”这件事干穿了!
不是聊天模型,是专为高频决策设计的System One:
1️⃣实时打Doom,每秒约10次决策,1小时成本才$7
2️⃣Minecraft实测:2分钟自动生存只要1分钱,夜间自己躲僵尸,零额外提示
3️⃣延迟70-500ms,一次前向传播就能并行回答多个问题
4️⃣价格$0.042/百万输入token,输出几乎免费
5️⃣只输出结构化结果(Choice/Score/概率+置信度),零类型错误,幻觉极低
6️⃣天生适合游戏Bot、Agent循环、客服分流这类「每秒都要做选择」的场景
这才是能真正跑进游戏里的AI大脑!
#Jev #TypeSafeAI #AIAgent #Doom #Minecraft #SystemOne
nitter.cf/nft_chen/status/210010…
Wyong retweeted
Stop building useless products.
How to find $10K+/m business ideas:
1. Go to the Flippa platform.
2. Filter websites doing $10,000+/m.
3. Pick an idea that has demand.
4. Analyze their marketing channels.
5. Build it if it's perfect for you.
Do SEO and other marketing...


Wyong retweeted

卧槽,JEV 的出现很可能就是自动智能交易的起点。
昨天JEV在AI 圈刷屏,今天 Monad 工程师就用JEV做了一个自动交易机器人。
实时读取 MON/USDC 价格,JEV 不负责写分析报告,也不跟你解释一堆逻辑,它只做最核心的事,判断 Buy 还是 Sell,再给出置信度,然后直接把交易发到 Kuru 的链上订单簿执行。
这一下我突然明白 JEV 为什么要做成一个不会说话的模型了。
交易根本不需要 AI 每 300ms 给你写一篇小作文,它需要的是:
行情进来→判断→下单→新行情→重新判断,而且这一整套循环必须足够快、足够便宜。
而 Monad 现在刚好每 300ms 出一个区块,Kuru 又是链上订单簿。高性能链负责执行,JEV 负责决策,两个东西拼起来,已经有点AI 原生交易系统的味道了。
未来的交易 Agent,不一定需要一个会写研报的超级大模型,它更需要一个能在极低延迟下连续做几百万次判断的大脑。
昨天我 提交的WL今天也通过了,接下来我先尝尝咸淡,看看到底怎么个事。

卧槽,今天 AI 圈最火的模型,应该就是 JEV 了。
现在所有大模型都在拼更会说话、更会写、更像人,JEV 直接反着来,它根本不生成文字,只负责做判断和决策。
我已经迫不及待用JEV帮我决策自动交易股票和加密货币了😂
官方给的数据非常夸张:20—200 倍更快,40—400 倍更便宜,输入每百万 Token 只要 0.042 美元,输出 Token 直接免费。
我们今天用 GPT、Claude、Gemini 做自动化,经常是让模型先写一大段话,再让程序从里面抠出 JSON、标签、分数和下一步动作。
JEV 干脆把“说废话”这一步整个删了,直接告诉软件:
选 A 还是 B、概率多少、置信度多少。
客服分流、内容审核、Agent 路由、推荐系统、风控、交易信号过滤……现实世界里大量 AI 调用,本来就不是为了让它写小作文,而是为了让它每秒做成千上万个判断。
这也是我觉得 JEV 最值得关注的地方。
目前 JEV 还在 Early Access,感兴趣的同学可以先去加入白名单等体验。
Wyong retweeted
15 AI SEO Agent Jobs
(Currently running on GPT-6 Astra)
1. Keyword Research
2. Search Console
3. AI Mentions
4. Citation Gaps
5. Opportunity Scoring
6. Topical Authority
7. Content Briefs
8. LLM Structure
9. Internal Links
10. Cannibalization
11. Content Refresh
12. Technical Audits
13. Link Outreach
14. Link Exchange
15. SEO Reporting

Wyong retweeted
分享一个奥地利兼职开发者打爆细分需求,跑出 MRR $3,458,利润率 80% 的真实案例。
开发者是一位全职软件工程师,业余从事 KDP 出版3~4 年。他发现大部分独立创作者被繁琐的非核心流程拖垮,选品、查词、看竞品、搞封面、跑印厂参数、刷真实书评。于是他一个人全栈开发了「Publbee」,切口极其垂直,就是专门服务亚马逊 KDP(Kindle 自出版)创作者。
拆解其产品逻辑,有几个极具参考价值的细节:
1️⃣ 做强约束生图管道
只提供通用生图毫无价值, KDP 印刷对工程参数有严格要求:300 DPI、四周 0.125 英寸出血位,书脊厚度甚至必须按公式「内页数 × 纸张厚度系数」动态计算。普通生图上传 100% 格式报错,而他的封面工具底层锁死了印刷规则,一键生成就是可过审的商用级资产。
2️⃣ 精准解构亚马逊搜索算法
亚马逊后台规矩极严,每本书只给作者留了 7 个填关键词的格子,瞎填不仅没流量,还会被系统推给错误的受众。Publbee 做了一个反向查词功能,用户只要贴上同类爆款书的编号(ASIN),就能直接扒出对手到底靠搜什么词在闷声发财,把最精准的高转化词筛选出来填满这 7 个黄金坑位,比自己瞎想好上一万倍。
3️⃣ 用「积分互助机制」帮助新书合规冷启动
新书上线最怕零书评导致的零曝光、零转化,但花钱刷单又极易被亚马逊封号。他做了一个互评中心(Review Center),用积分机制解决这个问题。用户不能白嫖,必须先认真阅读并点评别人的书赚取积分,才能用积分换取其他认证用户对自己新书的真实长评,合规破解冷启动难题。
4️⃣ 自然增长引擎:免费插件 + 工具型 SEO
他的获客几乎没花广告费,全靠两套自然流打法:
一是提供免费的 Chrome 功能插件。作家们在刷亚马逊时,插件会直接在商品边上展示预估销量和 BSR 排名,把工具做进用户日常习惯,顺便把人再带回网站。
二是做单点功能的 SEO 工具页。把「反向查词」、「找冷门赛道」等每个小功能单拎出来做专属工具内页,谁在 Google 搜具体痛点,谁就能搜到他,零成本精准获客。
做细分赛道却想着用 AI 替用户包办一切,纯粹是自己没有深入用户群体调研导致的。
只有真正深入其中,才会有体感。才会知道创作者最烦的不是写作本身,而是平台那些琐碎又苛刻的发行规则、是只会写作不会营销的分发难题。只需要帮他搞定这些麻烦事,哪怕圈子再小,大家也愿意痛痛快快来个订阅。
