








salomechen retweeted

بعد وصولي من رحلة لندن أبلغني مدير المقصورة أن فيه راكب عنده سؤال ويريد مقابلتي .. قلت حياه الله
وأثناء خروجي من الطائرة وجدت الراكب ينتظرني على الجسر وبعد السلام قال لي..
"يا كابتن.. صورت هذا المقطع أثناء الرحلة ولاحظت حركة هالزعنفة طول الطريق وحبيت أعرف منك شخصيا وش وظيفتها.. صراحة محيرتني"
شغل لي المقطع وكان مصور الزعنفة الصغيرة Flaperon وهي تتحرك باستمرار أثناء الطيران.. كما تشاهدونها في الفيديو المرفق.
حقيقة شدني سؤاله.. وفي نفس الوقت أحزنني أنه ظل يراقب حركة هالزعنفة من لندن إلى جدة والسؤال يدندن في رأسه طوال الرحلة 🤔
عموماً...هالزعنفة اسمها Flaperon وهي جزء من نظام مخصص لقمع المطبات الهوائية أثناء التحليق.. يتوفر هذا النظام في أغلب الطائرات عريضة البدن .. ورغم أن فكرة هذا النظام موجودة في بعض الطائرات منذ سنوات إلا أن البوينغ طورتها في الـ787 بشكل ملحوظ لتصبح أكثر دقة وكفاءة في التعامل مع المطبات الهوائية.. يعتمد هذا النظام على أجهزة استشعار دقيقة موزعة في أجزاء مختلفة من الطائرة ترصد باستمرار تغيرات الرياح والاضطرابات الجوية وخلال جزاء من الثانية يرسل النظام أوامر إلى هذه الزعنفة وهي متواجدة في الجناحين لتتحرك بعكس الحركة التي يسببها المطب فتقلل من قوته وتخفف جزء كبير من الأحمال الناتجة عن المطب.. لذلك يكون الإحساس بالمطبات أخف بكثير على الركاب وأكثر راحة..
وبما أن هذا السؤال قد يخطر على بال كثير من المسافرين قلت أشارككم المقطع والإجابة.. وسلامتكم.
中国911事件啊。这其实算恐怖袭击,当然会全网删除。这家学校的老板员工也是无妄之灾啊。

【“屠屠老湿”再曝北京撞机细节:撞“中国尊”前3分钟,小飞机险跟海航客机相撞?】
根据Flightradar24公开飞行轨迹,6月26日北京撞机事件当天,海南航空HU7146航班(空客A330-343,注册号B-5935)正执行乌鲁木齐地窝堡国际机场飞往北京首都国际机场任务。北京时间17时52分左右,飞机在进近首都机场过程中出现一次异常爬升,原本已下降至约800米高度准备落地,随后突然快速爬升至约2400米,之后重新加入进近程序并安全降落。此次异常爬升距离官方通报的北京撞楼时间(17时55分)仅约3分钟。
对此,博主“屠屠老湿”援引业内人士爆料称,撞楼的轻型运动飞机在飞行过程中,不知有意还是无意,迎着这架正进近首都机场的海南航空A330飞去,导致该客机触发TCAS(Traffic Collision Avoidance System,空中防撞系统)避撞警告。机组随即执行爬升避让,待危险解除后重新加入进近程序并安全降落。
TCAS是民航客机的重要安全系统。当系统判断两架飞机存在碰撞风险时,会向飞行员发出RA(Resolution Advisory,避撞指令),要求立即爬升或下降。按照国际民航运行规则,飞行员收到TCAS避撞指令后,应优先执行系统指令。
但截至目前,相关说法主要来自网络爆料和公开飞行轨迹分析,未获得官方证实,小编会继续追踪和补正新进展。
消息来源:nitter.cf/ttls2024/status/207135…


salomechen retweeted

给阿嬷的情书和泡沫破裂之后的影视作品有一个共同点是:不遗余力地宣传家庭在动荡背景下对个人心理的庇护(?,宣扬家庭价值和一种“此心安处即吾乡”的感觉,类似的比如《阿甘正传》。
明白人都知道男的一定是到处讨小老婆,这里一房那里一房,但导演依旧创造了这样的故事,好像在这样的一个故事和潮汕方言下,这些守着家、守着宗族秩序、要一直生生生直到生出儿子的女人的血泪就可以被掩盖一样。
这就好像一个人拍被拐卖到山村的女大学生和拐卖家庭里将来要被交换给别的家庭以换取那个家庭里的女孩嫁给自己哥哥的小女孩结下了深厚的情谊。这样的叙述无疑是对拐卖产业链残暴之处的粉饰太平,给阿嬷的情书也是同样的道理。
在这一点上我觉得做得最好的是《东京奏鸣曲》,因为它完全不避讳经济不景气下的社会可以揉搓一个人、一个家庭到何种程度,人们又是怎么样从行动中挖掘力量的,非常诚实,也非常真挚。
@Phosphas
salomechen retweeted
马英九本人发声明:不接受夫人与大姐的安排!不退休!继续查萧旭岑!
马英九声明稿之一:
关于本人之配偶周美青及大姐马以南,昨晚出于爱护之心发出之声明,因事先未经本人过目同意,对此本人深感错愕与遗憾。
本人在此郑重表示,绝不能由马以南安排或执行本人之医疗等个人事务,也不能由她代表马家亲属发言,更完全不能同意马以南的主张,将马英九基金会事务,全数交由现任的董事会成员处理。
本人再次强调,马英九基金会应尽速征聘廖继斌、戴遐龄、邱淑媞、赖幸媛等四位新董事,以增加董事会的多元性与公信力,共同协力和高华柱董事彻底整顿基金会事务。
马英九声明稿之二:
115年2月16日,我委讬高华柱及金溥聪两位先生,来协助马英九基金会所发生涉及刑法侵占与背信罪的案件。
外界有人说我的决策都不是出自我的本意这全非事实,有关萧王二人涉嫌侵占与背信的各项事实,他们都有向我报告,我都十分清楚了解,黄律师也都有向我详细说明,我了解之后,感到痛心疾首,因为我培植他们十多年,又邀他们来跟我共事,我对他们自然充分信任,因此万万没想到,他们在财务上,对我做了许多涉嫌刑法背信与侵占罪的事,让我深感痛心疾首,难以释怀,因此决心追究到底,查明真相移送法办。
目前外界谣传我已失智,我听了觉得可笑,因为我虽然已76岁,每天依然读报看书及运动,与过去数十年并无二致,对于我过去培植提携过的萧王两位同仁,竟然做出这么多令人亲痛仇快的事,让我真的十分难过。
马英九
民国115年五月二十二日


salomechen retweeted

这哥们28分钟的视频教怎么写提示词
我看过300刀的课都没他前10分钟讲得透
Claude文档、记忆快捷键、并行对话、提示模式全给拆明白了
最骚的是完全免费
刚才点开一看已经5万多播放了
硬核分享
salomechen retweeted

近日,福建杨梅泡农药事件持续发酵。
博主“三少爷的剑”发长文讲述他从事三年助农项目、深入农村一线生活近两百天,被当地农民伤害的血泪史,彻底撕下了部分农户“淳朴”的面纱。


近日,福建浮宫镇、白水镇这两个拥有七百年杨梅种植历史的小镇,近日被媒体曝光违规使用“甜度为蔗糖8000倍”的复合甜味剂,以及国家明令禁止用于水果的防腐剂-氢乙酸钠 来浸泡杨梅。
视频中,工人将整筐杨梅直接浸入装有浑浊液体的白色塑料桶中,浸泡数十秒后沥干装箱发货,就连工人自己都不敢吃:“这个不能吃,是给顾客吃的,你(记者)去吃没泡过的”
据医生介绍,糖精钠和甜蜜素过量摄入,容易出现头晕、头痛、乏力、记忆力减退等症状,对青少年则会产生严重影响包括记忆力减退,严重脏器损伤。
媒体曝光后,浮宫镇、白水镇的杨梅收购价从往年的十几块一斤暴跌到2元多一斤,都不够采摘成本,果农们普遍血本无归,纷纷叫苦连连,不少农户索性把滞销的杨梅全部倒掉。
有网友批评:杨梅泡药水,早就是行业内公开的秘密,这么多年来你们心知肚明,却一个个装糊涂闭口不提,只顾着赚钱,眼睁睁看着我们把浸泡药水的杨梅买回去吃。现在事发了,影响你们的杨梅销售了,又装作委屈巴巴地说杨梅卖不出去了,快来帮帮我们。
salomechen retweeted

爱看书的人有福了!
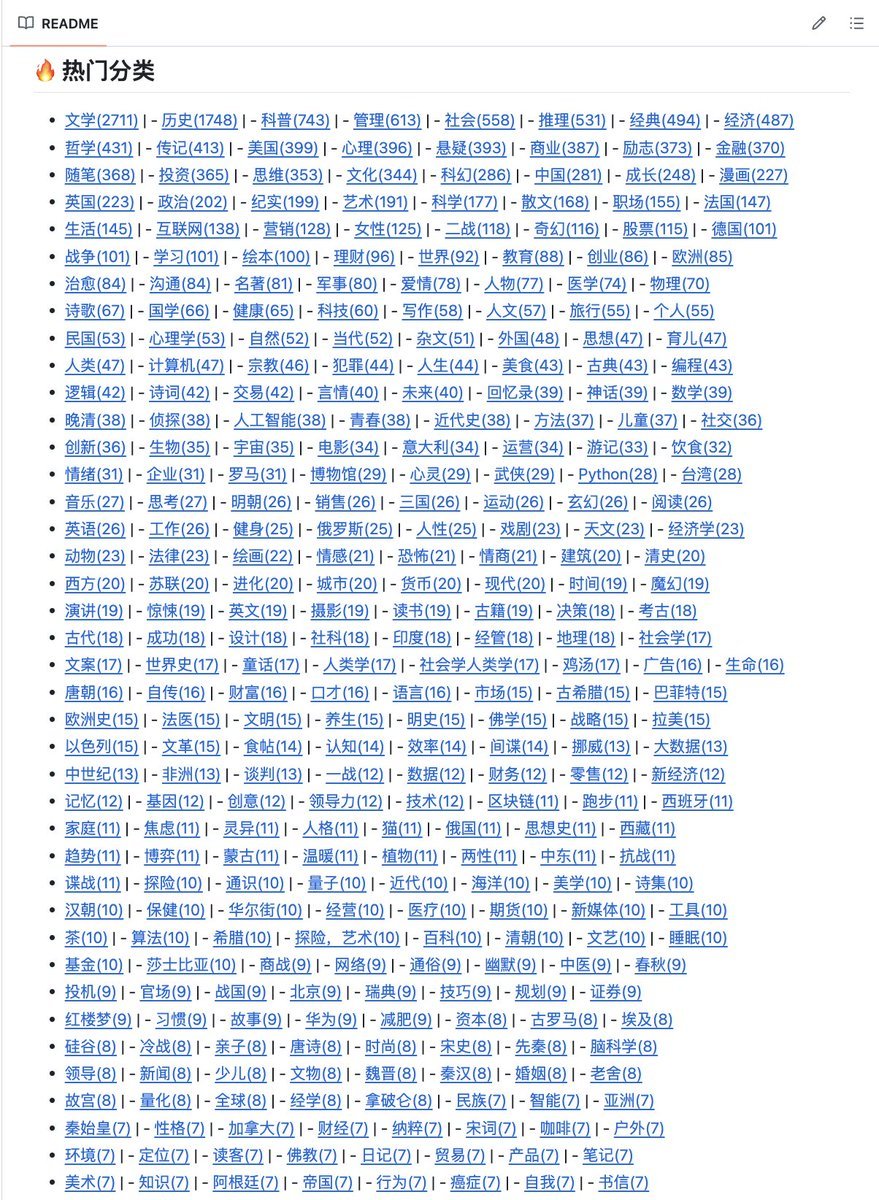
在GitHub挖到一个电子书资源大本营 EBOOK ETC,直接把微信读书、京东读书、喜马拉雅等平台的书都集中到一起找。
经典文学、经管励志、职场创业、技术手册……不管你想看哪类,
标签分类 + 搜索超方便。
最爽的是很多书直接附 epub、mobi、azw3 三种格式,Kindle、各大阅读器秒开无压力。
GitHub地址:github.com/jbiaojerry/ebook-…
喜欢的快去收藏,找书效率直接拉满!
salomechen retweeted

最新分享,小米大模型团队负责人罗福莉3个半小时专访
她曾供职阿里达摩院、DeepSeek,主导研发MiMo-V2系列模型。这是她首次接受长时间技术深度访谈。
专访聊了2026年Claude Opus 4.6等技术引发的AI剧震、Anthropic路径判断、国内团队Pre-train代差消失后的Agent RL scaling策略、算力配比从3:5:1到3:1:1的转变,以及后训练组织重组等核心话题。
信息密度极高,干货满满,值得每一个关注AI未来的人细读。
保存下来慢慢看⬇️
🔗:pan.quark.cn/s/7a2a842177a4
salomechen retweeted
马斯克要到头了 ……
“ 根据纽约时报的一项调查,马斯克在过去二十年里一直把 SpaceX 当作某种’储蓄罐’,把这家公司当作金融工具,用来获取贷款并支撑他那些陷入困境的其他公司。”
请看纽约时报英文的详尽分析。

Elon Musk has used SpaceX as a kind of piggy bank over the last two decades, turning to the company as a financial tool to get loans and bolster his struggling companies, according to an examination by The New York Times. nyti.ms/4w8dInZ

Readers added context they thought people might want to know
Musk's ~$500M SpaceX loans (2018-2021) at low rates were repaid in full by end-2021 with ~$14M interest. Legal and routine for private company owners; Sarbanes-Oxley prohibition applies only to public firms.
nytimes.com/2026/04/24/tec…
lw.com/admin/upload/S…
salomechen retweeted

Hamming 80 岁那年录了一个总长 30+ 小时系列讲座 youtube.com/watch?v=AD4b-52j… ,后来汇集成 The Art of Doing Science and Engineering: Learning to Learn 这本书。amazon.com/Art-Doing-Science…


美国数学家Richard Hamming是图灵奖得主,计算机先驱,纠错码之父。
他说自己很早在Los Alamos见过Feynman费曼、Oppenheimer奥本海默等。他承认自己当时很嫉妒,凭什么大家都是物理人,你们这些人是大牛人?
他后来在贝尔实验室Bell Labs继续观察Shannon香农、这些人,为什么有些人做到了,而其他人只是差点做到了?
“运气”只能解释一半。具体做成哪一个题,当然有运气。
Hamming自己也承认,他和Shannon香农同在贝尔实验室Bell Labs,同一时期一个做coding theory,一个做information theory,确实有运气成分。
但Einstein爱因斯坦、Shannon香农这类人可以反复做出好东西。一次可以说是撞上了,反复撞上,就要看准备工作、胆量和选择了。
机会会飘过很多人身边,但只有少数人已经在脑子里预留了接口。
他讲,重要问题不是结果影响听起来多大。比如时间旅行、传送、反重力,结果影响当然巨大,但手里没有合理的入口,也只能供人幻想。
一个真正该上的科题,要同时有分量和入口,如果做成,它会改变一些东西;而你现在又能找到一条可以攻进去的路。
很多聪明人输在这里。他们每天忙忙碌碌,设计问题很精致,方法很专业,可心里其实知道,这些东西就算做完,也很难通向更大的东西。
Hamming每周五中午以后给自己留“Great Thoughts Time”,只聊大问题,比如计算机会怎样改变科学?
这听起来像偷懒,其实是给自己留10%的雷达时间。
你如果一周五天都在处理眼前小事,很容易把效率误认为方向。你会变成一个很勤奋、很可靠、很会交付的人,然后十年后发现,自己一直在小问题上越做越熟。
Hamming还有一个观察:
关着门工作的人,完全隔绝噪音,短期内很舒服,貌似产出更高;长期看,你会错过那些不成体系、没法写进报告、但能告诉你“问题变了”的信号。
而开着门工作的人,虽然经常被打断,但更可能知道世界的新动向。一流工作需要深度,也需要暴露在真实问题流里。
他讲,成名后的危险,也很像今天的创业者、研究者和内容创作者。
一旦做出一个大东西,人会不愿意再种小种子,只想一上来就抱大树。Hamming说Shannon香农在信息论之后,可能就被“下一次必须同样伟大”这件事困住了。
早期的伟大而会把人冻住。因为你不愿意再做那些小、丑、未成形、别人看不上的起点。
但大东西通常就是从这种小起点长出来的。
还有一点很多人不爱听。
做出来还不够,你要会把它讲出去。
Hamming说科学家讨厌“sell”这个词,觉得好东西应该自然被世界看见。可现实是,所有人都在忙自己的事。你写得不清楚,讲得不清楚,会议上不敢开口,别人就会翻过去。
所以表达不是包装,是研究的一部分。
一个想做一流工作的人,至少要会三种表达:
写清楚,在正式场合里讲清楚,在混乱的场合里也能讲清楚。
很多“事后诸葛亮”三周后写报告证明自己早就看对了,但时过境迁了。
才华放晚了也会变成旁白。
把“伟大”从天赋、环境、运气这些大词拽回到具体的日常动作:
你有没有固定时间想大问题。
你手里有没有10到20个真正重要、且可能进攻的问题。
你遇到一个机会时,能不能立刻看出它碰到了你哪一个老问题。
你做一个项目时,有没有顺手把它变成一类问题的方法,而不止交一个答案。
你有没有把自己的缺点拿来当借口。
你会不会和大的体系合作,借力秘书、同事、老板、听众、组织流程打战役,而不是一生耗在小型战斗里。
讲真,你可以说自己缺运气,缺资源,缺年轻,缺老板支持。那你有没有准备好?有没有选对问题?有没有留出想大问题的时间?有没有勇气押上去,把成果讲到别人愿意停下来听?
说到最后,很多所谓怀才不遇,可能只是长期没有管理自己。
salomechen retweeted

迄今为止,最真切的乌克兰报道:
基辅没垮,俄军炸不动了,乌克兰到底干了啥。
去年冬天我又在基辅地铁站里充电,旁边大爷用太阳能板给收音机供电,还塞给我一块巧克力。他说现在停电比下雨还平常,但医院、指挥所、手机信号塔,从来没真断过。我以前觉得打仗就是炸电厂、炸工厂、炸首都——可现在电厂炸了,街口小超市的冰箱照样冷,社区诊所的呼吸机照常响。
他们真不靠奇迹活着。我表哥在利沃夫修无人机,厂子就藏在旧面包房地下,30个人轮班,干的是以前一个大兵工厂的活。他手机里存着几百个零件图纸,哪台机器坏了,隔壁五金店老板马上送新轴过来。德国人送来的机床不是摆在展厅里,是直接焊进车间墙里,师傅边用边学怎么调精度。
能源也变了。我家楼顶装了光伏板,政府补一半钱,剩下自己掏。邻居老奶奶卖腌黄瓜攒的钱,买了个移动发电机,说“万一哪天全城黑,我起码能给孙子手机充个电”。DTEK公司在基辅郊区建了个大电池阵,听说明年还要扩建。他们不再讲“总发电量多少”,而是说“医院供电能撑几天”“指挥车充电要多久”。
指挥系统更怪。泽连斯基的直播从没固定过地方,有时背景是军用帐篷,有时是加油站便利店,有次我亲眼看见他对着镜头说话,话没说完就钻进一辆旧出租车走了。政府网站底下写着A计划和B计划,A是国产弹药产量,B是进口多少吨,连运费和关税都算得清清楚楚。
“无敌点”这词是我妈先说的。小区门口那个小棚子,冬天供暖、夏天供冰水,还能给手机充电。它没名字,就挂个红十字旗。里面放着热汤、耳塞、手电筒,还有几台老式收音机。没人派任务,大妈们轮流来,谁有空谁来。
俄军的导弹越来越便宜,可炸掉的东西越来越不值钱。一个FPV无人机一千美元,能干掉一辆百万美元的雷达车;他们砸了敖德萨一座老变电站,结果附近渔民自己拉线,用柴油发电机+光伏板给渔港供电。德国人帮忙建的那座热电联产厂,烧的是城市垃圾沼气,连烟囱都没冒几回烟。
这不是临时凑合。去年底我帮社区登记物资,看到一份表格上写着:沙袋存量、混凝土预制块编号、反无人机网部署点位、备用通信频段列表。连修水管的焊工都知道,炸断主干管之后,前3个小时该接哪3条支线。
有人还说乌克兰靠外援硬撑。可我看德国工程师在哈尔科夫教焊工怎么校准炮管夹具,美国顾问在扎波罗热调试数据链终端,北欧人蹲在车间里改SOP流程表——他们不是来送钱的,是来教怎么把工厂拆成几百个零件,再重新拼起来。
前线士兵用的炮弹,引信是敖德萨小作坊做的,弹壳是第聂伯罗钢厂压的,火药配方去年刚国产化,检测标准直接套用北约。152毫米炮弹打出去,落点偏差比以前小了三分之二。
我去年十月去利沃夫火车站接人,广播响了三次空袭警报,没人跑,都在低头看手机。一个穿校服的女孩边等车边刷题,她妈妈在旁边给平板充电,用的是折叠太阳能板,巴掌大一块。
战争没让乌克兰停下,反而逼它把所有“不能倒”的东西,全换成小块的、可替换的、能藏着的、坏了马上能换新的。
去年春天我路过基辅老电厂,铁架子还在,但旁边多了三排光伏板,底下停着几辆移动储能车。工人说,以后这地方不发大电,只供隔壁医院备用。
我没再听说谁因为断电死在手术台上。也没听说哪个营级指挥部,因为网络中断丢掉前线信息。
他们不是没被炸,是炸了也停不下来。
乌克兰人现在不说“重建”,只说“接上”。
接上线,接上电,接上数据,接上人。
接上了,就还能动。


salomechen retweeted

是的,在美国学线性代数的都用过老爷子的教材。
美国的数学教材确实写得非常好,不像中国的数学教材都是定理、推论等罗列,然后死教条论证以及举几个例子,让人觉得数学就是很枯燥的东西。
我到了美国以后,拿美国数学教材,半自学地把这些数学课重新学习了一遍,才真正认识到数学的美,数学应用在实际中的不可思议。 – at Queens, NY

An MIT professor taught the same math course for 62 years, and the day he retired, students from every country on earth showed up online to watch him give his final lecture.
I opened the playlist at 2am and ended up watching three of them back to back.
His name is Gilbert Strang. The course is MIT 18.06 Linear Algebra.
Every machine learning engineer, every data scientist, every quant, every self-taught programmer who actually understands how AI works learned the math from this one man. Most of them never set foot on MIT's campus. They just opened a free playlist on YouTube and let him teach.
Here's the story almost nobody tells you.
Strang joined the MIT math faculty in 1962. He retired in 2023. That is 61 years of standing at the same chalkboard teaching the same subject to 18-year-olds.
The interesting part is what he did when MIT launched OpenCourseWare in 2002. Most professors were skeptical. They worried that putting their lectures online would make their classrooms irrelevant. Strang did not hesitate. He said his life's mission was to open mathematics to students everywhere. He filmed every lecture and gave it away.
The decision quietly changed how the world learns math.
For decades linear algebra was taught the wrong way. Professors started with abstract vector spaces and proofs about field axioms. Students drowned in the abstraction. Most never recovered. They walked out believing they were bad at math when they had simply been taught in an order that nobody's brain is built to absorb.
Strang inverted the entire curriculum.
He started with matrix multiplication. Something you can write down on paper. Something you can compute by hand. Something you can see. Then he showed his students that everything else in linear algebra eigenvectors, singular value decomposition, orthogonality, the four fundamental subspaces was just a different lens for understanding what the matrix was actually doing under the hood.
His rule was strict. If a student could not explain a concept using a concrete 3 by 3 example, that student did not actually understand the concept yet. The abstraction was supposed to come last, not first. The intuition was the foundation. The proofs were just confirmation that the intuition was correct.
The second thing Strang changed was the classroom itself. He said please and thank you to his students. Every single lecture. He paused mid-derivation to ask "am I OK?" to check if anyone was lost. He never used the word "obviously" or "trivially" because he knew exactly what those words do to a student who is one step behind. He treated 19-year-olds learning math for the first time the way he treated his own colleagues. With patience. With respect. With the assumption that they belonged in the room.
For 62 years.
The result is something that has never happened in the history of education. A single math professor became the default teacher of his subject for the entire planet.
Universities in India, China, Brazil, Nigeria, every country with a computer science department, started telling their own students to just watch Strang's lectures. The University of Illinois revised its linear algebra course to do almost no in-person lecturing. The reason was honest. The professor said they could not compete with the videos.
His final lecture was in May 2023.
The auditorium was packed with students who had never met him before. He walked to the chalkboard, taught for an hour, and at the end the entire room stood and applauded. He looked confused for a moment, like he genuinely did not understand why they were cheering. Then he smiled and waved them off and walked out.
His written comment under the YouTube video of that final lecture was four sentences long. He said teaching had been a wonderful life. He said he was grateful to everyone who saw the importance of linear algebra. He said the movement of teaching it well would continue because it was right.
That was it. No book promotion. No farewell speech. No legacy management.
The man whose teaching is the foundation of modern AI just thanked the audience and went home.
20 million views. Zero ego. The entire engine of the AI revolution sits on top of math that millions of people learned for free from one quiet professor in Cambridge.
The course is still on MIT OpenCourseWare. Every lecture, every problem set, every exam, every solution. Free.
The most important math course of the 21st century is sitting one click away from you. Most people will never open it.

salomechen retweeted

MIT一招,直接把AI巨头过去5年的百亿“上下文窗口军备竞赛”打成笑话!
所有大模型最头疼的“Context Rot”(上下文腐烂)终于被干掉了!
MIT CSAIL三位研究员刚放出的RLM(Recursive Language Models)直接把规则改了:
✅ 超长文档不再塞进AI窗口,而是以外部Python变量存着
✅ AI像顶尖程序员一样写代码:正则搜索、结构导航、精准切片
✅ 需要哪块就只拉哪块,读完后递归生成子AI并行分析,再主AI合成答案
✅ 无总结、无丢失、无性能衰减
实测结果炸裂:
• 最难的长上下文基准上,传统前沿模型接近0分
• RLM直接双位数百分比提升
• 可处理1000万token(主流模型原生窗口的100倍!)
• 成本甚至更低
代码已开源,GitHub一键替换现有LLM调用,零改动就能支持以前完全不可能的超长任务。
上下文窗口战争?结束了。
MIT不是把窗口做更大,而是直接走出了战场。
这才是2026年真正的具身智能/长期Agent杀手级方案。
(原论文+完整代码已附👇)


MIT just made every AI company's billion dollar bet look embarrassing.
They solved AI memory. Not by building a bigger brain. By teaching it how to read.
The paper dropped on December 31, 2025. Three MIT CSAIL researchers. One idea so obvious it hurts. And a result that makes five years of context window arms racing look like the wrong war entirely.
Here is the problem nobody solved.
Every AI model on the planet has a hard ceiling. A context window. The maximum amount of text it can hold in working memory at once. Cross that line and something ugly happens — something researchers have a clinical name for.
Context rot.
The more you pack into an AI's context, the worse it performs on everything already inside it. Facts blur. Information buried in the middle vanishes. The model does not become more capable as you feed it more. It becomes more confused. You give it your entire codebase and it forgets what it read three files ago. You hand it a 500-page legal document and it loses the clause from page 12 by the time it reaches page 400.
So the industry built a workaround. RAG. Retrieval Augmented Generation. Chop the document into chunks. Store them in a database. Retrieve the relevant ones when needed.
It was always a compromise dressed up as a solution.
The retriever guesses which chunks matter before the AI has read anything. If it guesses wrong — and it does, constantly — the AI never sees the information it needed. The act of chunking destroys every relationship between distant paragraphs. The full picture gets shredded into fragments that the AI then tries to reassemble blindfolded.
Two bad options. One broken industry. Three MIT researchers and a deadline of December 31st.
Here is what they built.
Stop putting the document in the AI's memory at all.
That is the entire idea. That is the breakthrough. Store the document as a Python variable outside the AI's context window entirely. Tell the AI the variable exists and how big it is. Then get out of the way.
When you ask a question, the AI does not try to remember anything. It behaves like a human expert dropped into a library with a computer. It writes code. It searches the document with regular expressions. It slices to the exact section it needs. It scans the structure. It navigates. It finds precisely what is relevant and pulls only that into its active window.
Then it does something that makes this recursive.
When the AI finds relevant material, it spawns smaller sub-AI instances to read and analyze those sections in parallel. Each one focused. Each one fast. Each one reporting back. The root AI synthesizes everything and produces an answer.
No summarization. No deletion. No information loss. No decay. Every byte of the original document remains intact, accessible, and queryable for as long as you need it.
Now here are the numbers.
Standard frontier models on the hardest long-context reasoning benchmarks: scores near zero. Complete collapse. GPT-5 on a benchmark requiring it to track complex code history beyond 75,000 tokens — could not solve even 10% of problems.
RLMs on the same benchmarks: solved them. Dramatically. Double-digit percentage gains over every alternative approach. Successfully handling inputs up to 10 million tokens — 100 times beyond a model's native context window.
Cost per query: comparable to or cheaper than standard massive context calls.
Read that again. One hundred times the context. Better answers. Same price.
The timeline of the arms race makes this sting harder. GPT-3 in 2020: 4,000 tokens. GPT-4: 32,000. Claude 3: 200,000. Gemini: 1 million. Gemini 2: 2 million. Every generation, every company, billions of dollars spent, all betting on the same assumption.
More context equals better performance.
MIT just proved that assumption was wrong the entire time.
Not slightly wrong. Fundamentally wrong. The entire premise of the last five years of context window research — that the solution to AI memory was a bigger window — was the wrong answer to the wrong question.
The right question was never how much can you force an AI to hold in its head.
It was whether you could teach an AI to know where to look.
A human expert handed a 10,000-page archive does not read all 10,000 pages before answering your question. They navigate. They search. They find the relevant section, read it deeply, and synthesize the answer.
RLMs are the first AI architecture that works the same way.
The code is open source. On GitHub right now. Free. No license fees. No API costs. Drop it in as a replacement for your existing LLM API calls and your application does not even notice the difference — except that it suddenly works on inputs it used to fail on entirely.
Prime Intellect — one of the leading AI research labs in the space — has already called RLMs a major research focus and described what comes next: teaching models to manage their own context through reinforcement learning, enabling agents to solve tasks spanning not hours, but weeks and months.
The context window wars are over.
MIT won them by walking away from the battlefield.
Source: Zhang, Kraska, Khattab · MIT CSAIL · arXiv:2512.24601
Paper: arxiv.org/abs/2512.24601
GitHub: github.com/alexzhang13/rlm

salomechen retweeted

今天简单说乌克兰在匈牙利大选后的操作。应该说欧盟政治韧性惊人。在受美俄同时威胁、挤压,风雨飘摇的情况下,严格遵循制度操作,大量磋商、投票,捏合了各国左中右政府,并成功拔掉了俄国扎进来的刺。
很多人觉得匈牙利这么捣乱,欧盟怎么不把它踢出去,而是它不停一票否决,欧盟不停找替代方案。
因为民主就是这么运作的。过于古板会引入风险,但抛开法律和程序,有更长久更恶劣的负面影响。
匈牙利剧变后,地缘政治有巨大变化。首先压力给到了斯洛伐克这边,而菲佐在国内没有欧尔班这样的威望和铁盘,估计会马上服软。而泽连斯基也借此立刻拉拢盟友。
- 友谊输油管道,匈牙利反对派获胜以后,乌克兰拖了几个月都没修好的管道,6天就迅速修好了。也算是对匈牙利表达了善意。
- 乌克兰的生命线,欧盟最重要的900亿贷款放行在即,估计欧尔班5月10日下台之后10天内就能搞定。
- 这一轮乌克兰外交的重点是德国,德乌签订国防合作协议、关系提升到战略伙伴。更关键的是,在双方的发言人,两国的口气基本是对等关系。这也说明乌克兰已经是欧洲举足轻重的大国了。
- 在到达德国之前,西班牙、比利时分别给泽连斯基送来了礼物。包括20亿欧元援助,附加更多的F-16战斗机,以及零件和维护人员。这甚至不是热门新闻。大家已经完全默认他就是能白拿那么多。
- 德国表示会考虑把乌克兰难民送回去参军。这估计是泽连斯基开口提要求了。目前德国登记的乌克兰难民数为135万,其中35万是符合征兵条件的成年男性。两周前,朱拉尼过来开口索要叙利亚难民。估计德国会找个方法两波人一起送走。虽然有一些经济和法律障碍。
- 德国送上40亿欧元军援。
- 第二站是挪威,双方签订了深化防务伙伴关系的宣言。挪威是2026年乌克兰最重要的援助国之一,援助金额高达850亿克朗(91.4亿美元)。
- 英国表示将提供12万架无人机。与俄罗斯被冻结资产的利息10亿美元。
- 第三站意大利,没有实质支持,但是加深了关系,主要是来拉拢梅洛尼这个极右翼。她刚刚和特朗普因为伊朗战事发生了矛盾。
- 第四站荷兰,荷兰是铁杆盟友,所以就是稍作停留发了个声明。
- 第五站瑞典,去要鹰狮战斗机,只是给了模糊的承诺。但瑞典回访乌克兰并掏了40亿欧元。
- 沙特、阿联酋、卡塔尔,各自送上10年军购合作协议。
- 泽连斯基说接下来还会拉拢北高加索地区。挖俄罗斯墙角呢。
- 马扎尔胜选后,原本支持欧尔班的中美俄,中国是立刻发了贺信,美国、俄国政府官员都没有。
- 万斯表态:“停止资助乌克兰是本届美国政府做的最让我自豪的事”。(见视频)
- 乌克兰现在对美国的态度:凉拌。基本不理会了。
老夫当时就说了,什么28条,18条,大家不要太花精力在上面,没意义。因为没诚意。之后俄军还是天天炸,乌克兰不停的改条款、拉盟友、谈判什么的,最后得到特朗普一句“乌克兰才是和平的阻碍”。据泽连斯基说,美方一直施压要求乌克兰让出剩余的乌战顿巴斯地区,这是不可接受的。卢比奥则回应说,美方只是转达俄罗斯的要求。
salomechen retweeted

Cat Wu 说了一句话让我印象很深,「Jobs are fake.」
她是 Anthropic Claude Code 的产品负责人,刚上了 Lenny's Podcast。这期信息量很大,我试着把核心的东西压缩一下。
Anthropic 的产品节奏已经快到不讲道理,功能从构思到上线,最快一天。不是因为用了最强模型(虽然确实有帮助),核心是组织和流程。几乎零审批、所有功能先以「研究预览」上线降低发布承诺、工程师端到端自己看到 Twitter 上的用户反馈就能周末把功能做完发出去,不需要经过 PM。PM 的角色不是审批门,是给团队搭好发射台,让工程师想发就能发,营销和文档能在第二天跟上。
最反直觉的是她对新模型的态度。别人上新模型是加功能,他们上新模型第一件事是删功能,把之前给模型打的补丁一个个撕掉。to-do list、强制提醒、各种 prompting 干预,模型变聪明了就不需要了。比如早期模型做 20 个 call site 的重构会漏改,团队加了 to-do list 工具强制跟踪;到 Opus 4 之后模型自己就会用,根本不需要提醒。她说每次模型升级,团队都会通读整个 system prompt,逐段问「模型还需要这个提醒吗?」不需要就删。播客里引用了一句话,「模型会把你的 harness 当早餐吃掉。」
但更重要的是提前构建「还不能工作的产品」。代码审查功能他们尝试了好几个版本,早期模型准确率不够一直没正式发。直到 Opus 4.5/4.6,团队才觉得可靠到工程师可以信赖它在合并前发现大部分 bug。她的建议是,永远提前做好原型,新模型一出来直接换进去验证差距是否被填上。
关于 PM 未来最稀缺的能力,她反复提到一个词,product taste。代码越便宜,品味越值钱。GitHub 上几万条 issue 什么需求都有人提,知道该做哪个、怎么做最好,这个判断力才是最值钱的。工程背景短期有用(能判断实现难度从而更好地做优先级决策),但她刻意只说「未来几个月」,因为每隔几个月模型能力就跳一级,所需技能跟着变,没人能预测更远。她觉得最重要的是第一性原理思维,搞清楚技术环境怎么变了,团队最缺什么,然后低自尊地戴上任何需要的帽子。
Anthropic 能跑这么快还有一个原因,使命统一。如果两个优先级冲突,问哪个更符合 Anthropic 的使命,答案就出来了,全员立刻执行。Cat 说了一句很重的话,「如果 Claude Code 失败了但 Anthropic 成功了,我会非常开心。」整个团队都愿意为公司目标牺牲自己产品的 KR。这种文化让决策极快,也是为什么一家起步晚、融资少、没有分发优势的公司能跑到 110 亿美金 ARR。
她对从业者几条比较实在的建议。
1/ 把重复劳动交给 AI,但别只做到 95% 就放弃。95% 准确率的自动化不是自动化,最后那 5% 才是真正值得投入的地方。
2/ 构建你真正每天在用的应用。One-shot 一个原型发个推然后再也不打开,你既没学到东西,也没获得杠杆。
3/ 别沉迷于炫耀 setup。她原话,「简单的配置往往效果更好。」有一群人花大量时间堆 skill 和 MCP,结果核心工作反而没做。
4/ 2024 的产品是对话式的,Claude Code 这一代产品是行动式的。当 AI 真正能代你执行而不只是告诉你该怎么做,那才是真正的顿悟时刻。
她的人生信条回到开头那句话,Just do things。理解约束,推导行动,然后直接去做。不要等许可,不要被岗位定义限制。这大概也解释了为什么 Anthropic 能跑这么快。

How Anthropic’s product team moves faster than anyone else
I sat down with @_catwu, Head of Product for Claude Code at @AnthropicAI, to get a peek into their unprecedented shipping pace, how AI is changing the PM role, and how to be the right amount of AGI-pilled.
We discuss:
🔸 How Anthropic’s shipping cadence went from months to weeks to days
🔸 The emerging skills PMs need to develop right now
🔸 Why you should build products that don't work yet—then wait for the model to catch up
🔸 Why a 95% automation isn't really an automation
🔸 Cat’s most underrated AI skill (introspection)
🔸 What Cat actually looks for when hiring PMs now (hint: it's not traditional PM skills)
Listen now 👇
youtu.be/PplmzlgE0kg
salomechen retweeted

后续来了兄弟们,卧槽真的太炸了,同样的任务,同样的配置,速度比Claude Sonnet 4.6还快 6 倍,成本低约 50 倍,
openrouter 和 官方 API 均限时免费 1 周使用时间,白嫖的机会,冲啊兄弟们!
我上周那条讲Elephant Alpha的推不是爆了吗,很多兄弟在评论区猜背后是谁,现在谜底揭晓了。
蚂蚁集团AGI团队(@AntLingAGI)的Ling-2.6-flash,
猜中国产大厂马甲的兄弟,你赢了。
说实话我看到架构数字那一刻,上周用它的所有体感全部对上了。
总参数104B,每次推理真正激活的只有7.4B,激活率7%,256个专家里每次只叫醒一小撮干活,其他的继续睡觉😂
这就是为啥上周我说它token消耗肉眼可见往下掉——100块钱的模型,每次推理只烧7块钱的算力,跑出了100块钱的智能,这可不是玄学啊,属于架构层面就在为效率让路。
再叠Linear Attention把传统Transformer的二次复杂度压下来,再加Multi-Token Prediction做推理加速,三件事一起上,FP8单卡341 tokens/s,Artificial Analysis实测输出215 tokens/s,和gpt-oss-120B并列第一梯队。
说实话,速度方面上周体验之后我早就服了,这回真正让我愣住的是跑分。
Artificial Analysis跑完全量评测,Ling-2.6-flash只烧了大约15M tokens,Nemotron-3-Super烧了接近10倍,Intelligence Score却拿到26,和Gemini 2.5 Flash同梯队。
都便宜到这个份上,大家下意识觉得肯定哪里凑合了,但agentic跑分直接打脸,SWE-bench Verified 62,BFCL-V4 67,TAU2-Telecom 93.86,SWE-bench测的是真实代码仓库里定位Bug加生成补丁,BFCL测的是函数调用准确性,全是硬场景,不是那种学术榜单刷分。
上周我搭那个串三个工具的小Agent跑得贼利索,现在明白了,这模型从训练阶段就是奔着Agent去的,别人做Agent是改装车,它是原厂出的Agent专用机。
所以我上周说的那套玩法现在有了官方解释——Claude管架构和规划调一次,Ling-2.6-flash管分步执行跑一百次,成本砍到十分之一,不是我瞎搭的野路子,是这个模型本来就为这个场景而生。
蚂蚁的产品线逻辑也清晰,Ling做基础,Ring做推理,Ming做多模态,这次先以stealth身份在OpenRouter和Kilo上免费放出来收集反馈,后面会开源,再推商用版LingDT,还会出BF16/FP8/INT4量化版。
路径就是社区验证→开源扩散→商业落地,对开发者来说,现在就是白嫖窗口期,免费还剩几天。
用了这段时间我给它的定位很明确,它是目前最适合一直开着的模型之一,Agent持续跑、代码补全随时触发、长文档批量处理,越高频越省钱,账单每个月都会替它说话。
但极端复杂的推理链、需要反复自我纠错的长思考任务,你可能还是得上重型推理模型,它的sweet spot是够聪明+极快+极省那个三角区,日常80%的活它接得住,接得还比大多数模型便宜。
所以说2026年看模型不能再盯着单一智能分了,当Agent从偶尔问一下变成24小时不间断跑的基础设施,每个token的有效产出就是新的胜负手,Ling-2.6-flash是目前这个方向上跑得最激进、也交出实际成绩单的选手之一。
上周说过的话,这周全部兑现,挺爽的🌚
#ElephantAlpha #Ling2Flash #AntAGI #Agent #大模型
🤝 Paid partnership

说个暴论,AI界的iPhone时刻可能就要到来了。
OpenRouter上最近杀出来一个匿名模型,把所有Agent开发者都打懵了。
它叫Elephant Alpha,没有发布会,没有营销通稿,连开发者是谁都不知道😂
纯靠用户口口相传,一周就冲到了平台日活前十,token使用量暴增377%。
我自己测了三天,结论是这他么才是2026年AI该有的样啊!
速度快到离谱,不是那种一个字一个字蹦的慢输出,是你刚敲完回车,一整段带注释的代码直接完整输出,体感和Grok 4 Fast差不多,但代码质量高一个档次。
最夸张的是智效比,同一份任务,完全相同的输出质量,它的token消耗是Claude Opus的一半,GPT-5.4的三分之一,账单是真的肉眼可见地往下掉。
它不是啥全能思考型模型,更像一个纯粹到极致的执行机器,跨十几个文件找Bug,256K上下文稳如狗,一点不丢引用。
几十页合同直接转成结构化的条款表,会议记录转待办,群聊转摘要,网页转初稿,所有你不想干的脏活累活,它干得又快又好。
唯一要注意的是它不会帮你脑补,指令越清晰,约束越明确,输出质量越爆炸,模糊的需求很容易得到平庸的结果,也不适合复杂的多步长链规划,知识时效性需要自己注入上下文。
最反直觉的地方来了,以前我们总觉得,什么活儿都得用最好的旗舰模型 ,但实际上你每天80%的工作,根本不需要Claude或者GPT的深度思考能力,你只是需要一个东西,能准确、快速、便宜地把事做完。
现在OpenClaw和Hermes社区已经形成了标准玩法,Claude管整体规划和架构设计,只调用一次。
Elephant管分步执行、局部修复、批量生成,跑一百次,整体效率翻三倍,成本直接砍到原来的十分之一甚至更低。
这才是Agent经济真正的突破口啊,以前Agent跑不起来,不是因为不够聪明,是调用一次太贵,延迟太高😟
当执行层的成本趋近于零的时候,所有自动化才真正变得可行。
更有意思的是匿名模型这个趋势,以后最好用的模型,可能都不是大厂发布会吹的那些。
OpenRouter的盲测机制,让模型纯靠真实使用数据说话,没有品牌溢价,没有营销滤镜,谁好用谁就会被用户用脚投票选出来。
社区普遍猜测这是某国产大厂的马甲在全球盲测,也侧面说明中国AI在推理优化赛道已经跑在了前面。
现在它还在盲测期,完全免费,256K上下文,32K输出,函数调用,结构化输出,全开放。
OpenRouter和Kilo Code上都能用,建议兄弟们把所有日常重复任务都切过去,把省下来的预算,留给真正需要深度推理的场景。
Elephant Alpha 是不是下一个ChatGPT 呢,我觉得不是,它更像是AI从偶尔炫技变成每天省事省钱的基础设施。
所以别再用大炮打蚊子了,模型分层才是2026年AI玩家的核心竞争力啊,
咱们工作流里有哪些活儿,其实根本不需要用旗舰模型🌚
#AI #大模型 #OpenRouter #ElephantAlpha #开发者 #Agent
salomechen retweeted

美国数学家Richard Hamming是图灵奖得主,计算机先驱,纠错码之父。
他说自己很早在Los Alamos见过Feynman费曼、Oppenheimer奥本海默等。他承认自己当时很嫉妒,凭什么大家都是物理人,你们这些人是大牛人?
他后来在贝尔实验室Bell Labs继续观察Shannon香农、这些人,为什么有些人做到了,而其他人只是差点做到了?
“运气”只能解释一半。具体做成哪一个题,当然有运气。
Hamming自己也承认,他和Shannon香农同在贝尔实验室Bell Labs,同一时期一个做coding theory,一个做information theory,确实有运气成分。
但Einstein爱因斯坦、Shannon香农这类人可以反复做出好东西。一次可以说是撞上了,反复撞上,就要看准备工作、胆量和选择了。
机会会飘过很多人身边,但只有少数人已经在脑子里预留了接口。
他讲,重要问题不是结果影响听起来多大。比如时间旅行、传送、反重力,结果影响当然巨大,但手里没有合理的入口,也只能供人幻想。
一个真正该上的科题,要同时有分量和入口,如果做成,它会改变一些东西;而你现在又能找到一条可以攻进去的路。
很多聪明人输在这里。他们每天忙忙碌碌,设计问题很精致,方法很专业,可心里其实知道,这些东西就算做完,也很难通向更大的东西。
Hamming每周五中午以后给自己留“Great Thoughts Time”,只聊大问题,比如计算机会怎样改变科学?
这听起来像偷懒,其实是给自己留10%的雷达时间。
你如果一周五天都在处理眼前小事,很容易把效率误认为方向。你会变成一个很勤奋、很可靠、很会交付的人,然后十年后发现,自己一直在小问题上越做越熟。
Hamming还有一个观察:
关着门工作的人,完全隔绝噪音,短期内很舒服,貌似产出更高;长期看,你会错过那些不成体系、没法写进报告、但能告诉你“问题变了”的信号。
而开着门工作的人,虽然经常被打断,但更可能知道世界的新动向。一流工作需要深度,也需要暴露在真实问题流里。
他讲,成名后的危险,也很像今天的创业者、研究者和内容创作者。
一旦做出一个大东西,人会不愿意再种小种子,只想一上来就抱大树。Hamming说Shannon香农在信息论之后,可能就被“下一次必须同样伟大”这件事困住了。
早期的伟大而会把人冻住。因为你不愿意再做那些小、丑、未成形、别人看不上的起点。
但大东西通常就是从这种小起点长出来的。
还有一点很多人不爱听。
做出来还不够,你要会把它讲出去。
Hamming说科学家讨厌“sell”这个词,觉得好东西应该自然被世界看见。可现实是,所有人都在忙自己的事。你写得不清楚,讲得不清楚,会议上不敢开口,别人就会翻过去。
所以表达不是包装,是研究的一部分。
一个想做一流工作的人,至少要会三种表达:
写清楚,在正式场合里讲清楚,在混乱的场合里也能讲清楚。
很多“事后诸葛亮”三周后写报告证明自己早就看对了,但时过境迁了。
才华放晚了也会变成旁白。
把“伟大”从天赋、环境、运气这些大词拽回到具体的日常动作:
你有没有固定时间想大问题。
你手里有没有10到20个真正重要、且可能进攻的问题。
你遇到一个机会时,能不能立刻看出它碰到了你哪一个老问题。
你做一个项目时,有没有顺手把它变成一类问题的方法,而不止交一个答案。
你有没有把自己的缺点拿来当借口。
你会不会和大的体系合作,借力秘书、同事、老板、听众、组织流程打战役,而不是一生耗在小型战斗里。
讲真,你可以说自己缺运气,缺资源,缺年轻,缺老板支持。那你有没有准备好?有没有选对问题?有没有留出想大问题的时间?有没有勇气押上去,把成果讲到别人愿意停下来听?
说到最后,很多所谓怀才不遇,可能只是长期没有管理自己。
salomechen retweeted

1880年,一个叫米尔顿·赫尔希的糖果商第三次破产了。
第一次在费城,开了一家糖果店,六年后关门。
第二次在纽约,做焦糖,撑了三年,又倒了。
第三次在芝加哥,连三个月都没撑过。
他回到宾夕法尼亚老家兰开斯特,口袋里什么都没有。
他的母亲范妮和姨妈玛蒂借给他一百五十美元。
他用这笔钱重新开始做焦糖。
这一次他改了一样东西——用鲜牛奶代替石蜡。
当时所有便宜糖果都掺石蜡来增加体积和光泽。赫尔希觉得那个口感不对,但用鲜牛奶成本高得多。
一个英国进口商路过他的摊位,尝了一颗焦糖,停下来了。
当场下了一笔订单。
赫尔希靠这笔订单翻了身。兰开斯特焦糖公司几年内做到了年销百万美元。
1893年,他去芝加哥世博会,看到了一台德国产的巧克力制造机。
他站在那台机器前面看了整整一天。
回来之后,他把焦糖公司以一百万美元卖掉了。
所有人都觉得他疯了——焦糖正在赚大钱,为什么卖?
他说了一句话:"焦糖是一阵风。巧克力是永远。"
他拿着卖焦糖的钱,在宾夕法尼亚乡下买了一大片牧场。
旁边什么都没有。只有奶牛。
他需要奶牛。因为他要做牛奶巧克力。
当时的巧克力是苦的,是奢侈品,只有欧洲富人吃得起。瑞士人发明了牛奶巧克力,但配方保密,价格极高。
赫尔希没有配方。
他关起门来自己试。
失败的巧克力倒掉了几千磅。工人们觉得老板在把钱往河里扔。
他的合伙人勒罗伊·莱斯特利来找他,说:"Milton,我们已经烧了两年的钱了。"
赫尔希从锅里舀出一勺巧克力浆,递给他尝。
莱斯特利尝了一口,不说话了。
1900年,赫尔希的牛奶巧克力上市了。
他定了一个价——一块巧克力五美分。
五美分。当时一杯咖啡的价格。
所有人都说太便宜了。他说:"我不是在卖奢侈品。我在卖每一个美国小孩放学路上买得起的东西。"
然后他做了一件事——他在工厂旁边建了一个镇。
给工人盖房子、建学校、修公园、铺有路灯的街道。
他把这个镇命名为赫尔希镇。
这还不是最疯狂的部分。
1909年,他和妻子凯瑟琳因为没有孩子,创办了一所孤儿学校。
1918年,凯瑟琳去世后三年,赫尔希把自己的全部财产——整个赫尔希巧克力公司的股权——悄悄转给了那所学校的信托基金。
没有通知董事会。没有通知媒体。
直到多年后审计时,人们才发现公司的实际拥有者是一群孤儿。
到今天,赫尔希信托基金仍然是赫尔希公司的控股股东。
基金的全部收益用于运营米尔顿·赫尔希学校,为贫困家庭的孩子提供免费教育和寄宿。
一百多年来,超过一万两千名孩子从这所学校毕业。
赫尔希1945年去世,享年八十八岁。
他没有亲生子女。
但一整个镇的孩子叫着他的名字长大。
他这辈子说过的话很少被记录下来。
但有一句流传了下来:
"给一个孩子一块巧克力, 你让他快乐了一个下午。 给他一所学校, 你让他有能力给自己买一辈子的巧克力。"